1. 题目描述
给你一个链表数组,每个链表都已经按升序排列。
请你将所有链表合并到一个升序链表中,返回合并后的链表。
// 示例 1:
输入:lists = [[1,4,5],[1,3,4],[2,6]]
输出:[1,1,2,3,4,4,5,6]

解释:链表数组如下:
[
  1->4->5,
  1->3->4,
  2->6
]
将它们合并到一个有序链表中得到。
1->1->2->3->4->4->5->6

// 示例 2:
输入:lists = []
输出:[]

// 示例 3:
输入:lists = [[]]
输出:[]2. 【方法一】暴力求解
一、回顾合并两个有序链表的情况
昨天做了 LC21 – 合并两个有序链表,这道题就是一个升级版,先回顾一下 LC21:
- 需要一个伪头节点
head(dum),保存合并结果的头部,这是为了方便书写; - 需要一个指针
tail(cur) 指向head,后面在结果链表插入的时候就使用 tail; - 需要两个指针
aPtr和bPtr分别记录两个待合并链表的第一位(会被不断更新为剩余的未合并部分的第一位); - 在合并的时候,先判断哪个链表的第一位更小,然后将更小的那个插入到结果链表的末尾(
tail->next); - 更新
tail和xPtr两个指针(都向后移动一位)。
二、思路
@leetcode 官方题解
最朴素的办法是,用一个变量 ans 维护已经合并的链表,在第 次循环把第 个链表和 ans 合并,并将结果保存在 ans 中。
三、代码 & 复杂度分析
/**
 * Definition for singly-linked list.
 * struct ListNode {
 *     int val;
 *     struct ListNode *next;
 * };
 */

/* 合并 2 个升序链表 */
struct ListNode* mergeTwoLists(struct ListNode* a, struct ListNode* b) {
    if (a == NULL || b == NULL) {
        return a != NULL ? a : b;
    }

    struct ListNode head;          /* 哑节点(栈上分配) */
    struct ListNode *tail = &head;
    struct ListNode *aPtr = a, *bPtr = b;

    while (aPtr != NULL && bPtr != NULL) {
        if (aPtr->val < bPtr->val) {
            tail->next = aPtr;
            aPtr = aPtr->next;
        } else {
            tail->next = bPtr;
            bPtr = bPtr->next;
        }
        tail = tail->next;
    }
    tail->next = (aPtr != NULL) ? aPtr : bPtr;

    return head.next;
}

/* 合并 K 个升序链表 */
struct ListNode* mergeKLists(struct ListNode** lists, int listsSize) {
    struct ListNode *ans = NULL;
    for (int i = 0; i < listsSize; ++i) {
        ans = mergeTwoLists(ans, lists[i]);
    }
    return ans;
}
/**
* Definition for singly-linked list.
* public class ListNode {
* int val;
* ListNode next;
* ListNode() {}
* ListNode(int val) { this.val = val; }
* ListNode(int val, ListNode next) { this.val = val; this.next = next; }
* }
*/
class Solution {
public ListNode mergeKLists(ListNode[] lists) {
ListNode ans = null;
for (int i = 0; i < lists.length; ++i) {
ans = mergeTwoLists(ans, lists[i]);
}
return ans;
}
public ListNode mergeTwoLists(ListNode a, ListNode b) {
if (a == null || b == null) {
return a != null ? a : b;
}
ListNode head = new ListNode(0);
ListNode tail = head, aPtr = a, bPtr = b;
while (aPtr != null && bPtr != null) {
if (aPtr.val < bPtr.val) {
tail.next = aPtr;
aPtr = aPtr.next;
} else {
tail.next = bPtr;
bPtr = bPtr.next;
}
tail = tail.next;
}
tail.next = (aPtr != null ? aPtr : bPtr);
return head.next;
}
}复杂度分析:
- 时间:
- 假设每个链表最长为 , 次合并后
ans的长度最长为 ; - 第 次合并时,
ans已经合并了 次,将要合并第 个链表,所以第 次的耗时就是 ; - 总的时间复杂度就是从 到 对 求和,结果是 。
- 假设每个链表最长为 , 次合并后
- 空间:空间复杂度为 。
2. 【方法二】分治合并
一、什么是分治法(Divide and Conquer)?
分治法可以概括为三个字:分、治、合:
- 分(Divide):把一个大问题,分解成若干个小规模的子问题;
- 治(Conquer):递归地解决这些子问题;
- 合(Combine):把所有子问题的解合并,得到原大问题的解。
二、思路
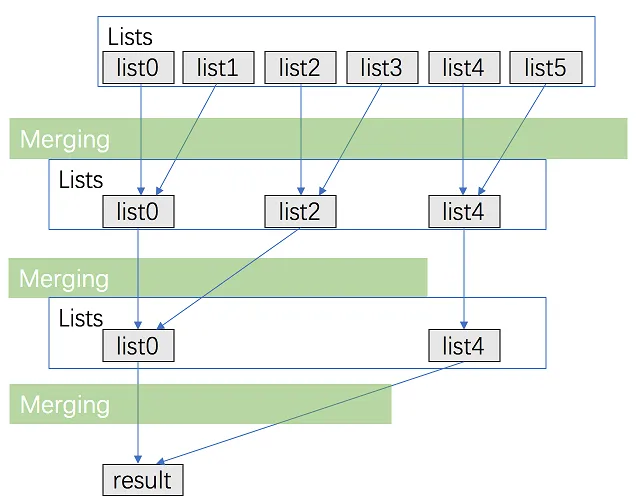
要将 k 个升序链表合并成一个,可以把这 k 个链表不断地平分成两组,直到分到只剩一个链表,最后两两合并回来。
例如有 7 个链表 [L1, L2, L3, L4, L5, L6, L7]:
- 分:拆分为
[L1, L2, L3, L4]和[L5, L6, L7]; - 再分:左侧
[L1, L2]和[L3, L4],右侧[L5, L6]和[L7]; - 治与合:两两合并(落单的直接进入下一轮),第一次得到
M12, M34, M56, M7,第二次得到M1234, M567,第三次合并后就是完整结果。
三、代码
struct ListNode* mergeTwoLists(struct ListNode* a, struct ListNode* b) {
    if (a == NULL || b == NULL)
        return a != NULL ? a : b;

    struct ListNode head; // 栈上哑节点(伪头节点 / 哨兵结点)
    struct ListNode *tail = &head;
    struct ListNode *aPtr = a, *bPtr = b;

    while (aPtr != NULL && bPtr != NULL) {
        if (aPtr->val < bPtr->val) {
            tail->next = aPtr;
            aPtr = aPtr->next;
        } else {
            tail->next = bPtr;
            bPtr = bPtr->next;
        }
        tail = tail->next;
    }
    tail->next = (aPtr != NULL) ? aPtr : bPtr;

    return head.next;
}


struct ListNode* merge(struct ListNode** lists, int l, int r) {
    // 边界情况 & 终止条件
    if (l == r)
        return lists[l];
    if (l > r)
        return NULL;

    /* 分:找中点 */
    int mid = (l + r) >> 1;

    /* 合:合并左右两部分 */
    struct ListNode* left = merge(lists, l, mid);
    struct ListNode* right = merge(lists, mid + 1, r);

    return mergeTwoLists(left, right);
}


struct ListNode* mergeKLists(struct ListNode** lists, int listsSize) {
    if (listsSize == 0 || lists == NULL) {
        return NULL;
    }
    return merge(lists, 0, listsSize - 1);
}class Solution {
public ListNode mergeKLists(ListNode[] lists) {
return merge(lists, 0, lists.length - 1); // 数组下标从 0 开始,故这里 r 减 1
}
public ListNode merge(ListNode[] lists, int l, int r) {
if (l == r) {
return lists[l];
}
if (l > r) {
return null;
}
// 相当于除以 2 并向下取整
int mid = (l + r) >> 1;
return mergeTwoLists(merge(lists, l, mid), merge(lists, mid + 1, r));
}
public ListNode mergeTwoLists(ListNode a, ListNode b) {
if (a == null || b == null) {
return a != null ? a : b;
}
ListNode head = new ListNode(0);
ListNode tail = head, aPtr = a, bPtr = b;
while (aPtr != null && bPtr != null) {
if (aPtr.val < bPtr.val) {
tail.next = aPtr;
aPtr = aPtr.next;
} else {
tail.next = bPtr;
bPtr = bPtr.next;
}
tail = tail.next;
}
tail.next = (aPtr != null ? aPtr : bPtr);
return head.next;
}
}mergeKLists 函数是主入口,只负责初次调用 merge。
merge 函数是分治递归的核心,其中 l 是当前处理区间的左边界,r 是右边界。
递归的终止条件:
- 当
l == r时,说明区间已经缩小到只剩一个链表,无需合并,直接返回这个链表即可,这时主要的终止条件; - 判断
l > r的目的是防止传入空数组。当lists长度为 0 时,margeKLists在调用时就会传入l = 0, r = -1。
一分为二 + 递归合并:
- 左半边处理:
merge(lists, l, mid)递归合并左半边的所有链表,返回一个合并好的左半边大链表; - 右半边处理:
merge(lists, mid + 1, r)递归合并右半边的所有链表,返回一个合并好的右半边大链表; - 合并:使用 mergeTwoList 将左右两边合并起来。
四、复杂度分析
时间
这种方法比上一种更好,两两合并完全平行进行
分治树的高度是 ,每一层的合并总代价都是 ,时间复杂度大幅简化到了 。
空间
主要的空间消耗来自递归调用栈,在递归到达最底层(l == r)并开始回溯合并时,系统调用栈最多会同时压入 个函数栈帧,因此递归栈带来的空间开销是 。
次要的空间开销来自伪头节点(哑节点),这是一个栈区的局部变量,每次函数出栈时,也会一并回收,其数量的峰值也是递归到达最底层时的 。
所以总空间复杂度 =
3. 【方法三】优先队列(手撕推荐)
一、什么是优先队列(PriorityQueue)?
和普通队列的区别:
- 普通队列:先进先出(FIFO);
- 优先队列:出队顺序不看先来后到,优先级高的(例如数值最大/最小的)元素先出;
底层数据结构:
- C 语言中,完全二叉树可用数组实现,这就是堆(Heap);
- Java 的 PriorityQueue 就是一个小项堆,每次弹出元素,都弹出当前堆里最小的。
Java PriorityQueue 常用 API:
Java 的标准库内置了优先队列,通过二叉小项堆(Min-Heap)实现
offer(E e)/add(E e):把元素放入队列(相当于 C 语言的插入堆并调整push_heap);poll():弹出并返回优先级最高的元素(默认是最小)。如果队列为空,返回null(相当于 C 语言的弹出堆顶并调整pop_heap);peek():只返回队头元素,不弹出;isEmpty():判断队列是否为空。
二、思路
这个方法和之前的方法不同,是比较直观的方法:
- 我们需要维护当前每个链表(剩余部分)的头结点;
- k 个链表就最多有 k 个满足这样条件的元素,每次在这些元素里面选取 val 最小的元素,插入到结果链表末尾;
- 我们使用优先队列(最小堆)实现高效地取最小。
三、代码 & 复杂度分析
C 语言标准库没有内置的优先队列,不能像 Java 一样直接调用,所以下面只给出 Java 版本。
对 C 语言来说,分治递归还是更好写一些。
class Solution {
    public ListNode mergeKLists(ListNode[] lists) {
        // 直接使用 Lambda 表达式定义比较器,无需包装类
        PriorityQueue<ListNode> queue = new PriorityQueue<>((a, b) -> a.val - b.val);

        // 初始化,所有非空链表的头节点入队
        for (ListNode node : lists) {
            if (node != null) {
                queue.offer(node);
            }
        }

        // 结果链表的哑节点和尾指针
        ListNode head = new ListNode(0);
        ListNode tail = head;

        // 核心循环
        while (!queue.isEmpty()) {
            ListNode node = queue.poll();
            tail.next = node;
            tail = tail.next;
            if (node.next != null) {
                queue.offer(node.next);
            }
        }

        return head.next;
    }
}复杂度分析:
- 时间:
- 每个节点都会入堆、出堆各一次,共
N次操作。 - 堆的大小不超过
K,每次堆操作 。 - 总计 。
- 每个节点都会入堆、出堆各一次,共
- 空间:
- 堆中最多同时存
K个节点。 - 结果链表复用原节点,不算额外空间。
- 堆中最多同时存
优先队列和分治相比,空间复杂度更逊、用时更长(但都是常数级的区别),但是思路更直观、更短,不容易写错。