[数据结构] 02 - 算法和算法分析
2.1 - 数据结构与算法的关系
Data Structures + algorithms =Program
- 数据结构:用于组织大量非数值计算数据的方法;
Data Structure: Methods of organizing large amounts of data for nonnumeric calculation ; - 算法:为解决某个问题而遵循的有限且明确指定的指令序列;
Algorithm: A finite, clearly specified sequence of instructions to be followed to solve a problem. - 算法分析:主要是对程序运行时间的分析
Algorithm Analysis: The estimation of the running time of algorithms
- 数据结构与算法的关系可以概括为:数据结构决定“数据怎么组织”,算法决定“数据怎么处理”。
- 例如我有一批数字,数据结构考虑的是如何保存这些数,算法考虑的是如何从这些数中找出某个数,或者怎么从中删掉某个数这种问题。
2.2 - 算法定义和特性
算法:是解决特定问题求解步骤的描述,在计算机中表现为指令的有序排列,并且每条指令表示一个或多个操作。
算法具有五个基本特性:
- 输入:算法具有零个或多个输入;
Input: There are zero or more quantities that are externally supplied. - 输出:算法具有一个或多个输出;
Output: At least one quantity is produced. - 有穷性:指算法在执行有限的步骤之后,自动结束而不会出现无限循环,且每一个步骤在可接受的时间内完成;
Finiteness: If we trace out the instructions of an algorithm, then for all cases, the algorithm terminates after finite number of steps. - 确定性:算法的每一步骤都具有确定的含义,不会出现二义性。
Definiteness: Each instruction is clear and unambiguous.- 算法的每个步骤被精确定义而无歧义。对于确定性算法,在相同输入和相同初始状态下,其执行过程和输出是确定的;随机算法则允许利用随机选择产生不同的执行路径。例如:
- “随机生成一个 1~10 的整数”的操作虽然结果是随机的,但本身意义非常明确,满足确定性;
- “生成一个差不多合适的数”就是不满足确定性的操作;
- 算法的每个步骤被精确定义而无歧义。对于确定性算法,在相同输入和相同初始状态下,其执行过程和输出是确定的;随机算法则允许利用随机选择产生不同的执行路径。例如:
- 有效性:每条指令都必须足够基本,原则上能够由一个人仅使用铅笔和纸来执行。
Effectiveness: Every instruction must be basic enough to be carried out, in principle, by a person using only pencil and paper.- 这个性质又称为可行性(算法的每一步都必须是可行的,也就是说,每一步都能够通过执行有限次数完成);
- 有效性的定义通常来自 Knuth《程序设计艺术》或受其影响的教材,这二者本质上是一样的,但有效性的表述更准确。
2.3 - 算法的效率
2.3.1 - 好的算法
算法不是唯一的,同一个问题可以有不同的解决方法。但是,能解决问题的算法不一定是好的算法:
- 正确性 Correctness:
算法的正确性是指算法至少应该具有输入、输出和加工处理无歧义性,能正确反映问题的需求,能够得到问题的正确答案。“正确”可以分为四个层次:- 算法没有语法错误;
No grammar mistakes; - 算法程序对于合法的输入数据能够产生满足要求的输出结果;
Expected outputs for legal inputs; - 算法程序对于非法的输入数据能够得出满足规格说明的结果;
Expected outputs for illegal inputs; - 算法程序对于精心选择的,甚至刁难的测试数据都有满足要求的输出结果;
Expected outputs for selective inputs.
- 算法没有语法错误;
- 可读性:算法设计的另一目的是为了便于阅读、理解和交流;
Readability: Easy to read, understand and communicate; - 健壮性:
当输入数据不合法时,算法也能做出相关处理,而不是产生异常或其他奇怪的结果;
Robustness: Can deal with illegal inputs; - 高效性:设计算法应该尽量满足程序执行时间短(时间效率高),和执行代码所需的最大存储空间小(空间效率高)的需求。
High efficiency: Time & Storage.
2.3.2 - 算法效率的度量方法
一、事后统计方法
事后统计方法:通过设计好的测试程序和数据,利用计算机计时器对不同算法编制的程序的运行时间进行比较,从而确定算法效率的高低。
Empirical: after implementation
事后统计方法有较大的局限性:
- 必须依据算法事先编写测试程序;
- 时间比较依赖计算机硬件和软件等环境因素;
- 测试数据设计困难,且部分算法可能在不同规模、不同特征的测试数据上可能有完全不同的表现。
二、事前分析估算方法
事前分析估算方法:在计算机程序编制前,依据数学方法对算法的效率进行估算。
Theoretical: before implementation
事前分析估算方法的三个基本假设:
- 指令顺次/顺序执行(executed sequentially);
- 每条简单指令耗时恰好为 1 个时间单位;
- 整数大小固定,且拥有无限内存。
一个高级语言编写的程序,在计算机上运行所消耗的时间取决于:
- 算法采用的策略、方法;
- 问题的规模(n);
- 编译产生的机器码质量;
- 机器执行指令的速度。
在事前分析中:
- 我们只关注前两个变量(算法的策略、问题的规模)而不关注后两个变量(编译质量和执行速度);
- 只统计“基本操作”,即算法中执行频率最高、处于最深层循环内部、执行时间不随问题规模 n 变化的原子级指令。
2.3.3 - 函数的渐进增长
一、事前分析估算方法的理论依据
函数的渐进增长: 给定两个函数 f(x) 和 g(x),如果存在一个整数 N,使得对于所有的 n > N,有 ,我们就说 f(n) 的增长快于 g(n)。
函数的渐进增长是事前分析估算方法的重要理论依据,因为某个算法可能会随着 n 的增大越来越优于/差于另一算法。
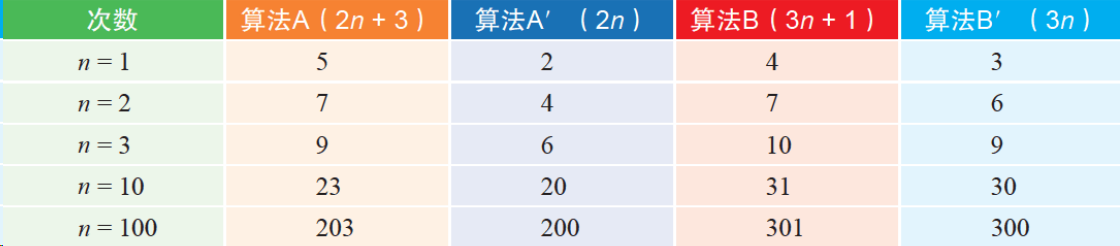
- 例1:我们发现,算法运行次数的变化基本不受常数项的影响,所以我们可以忽略加法常数。
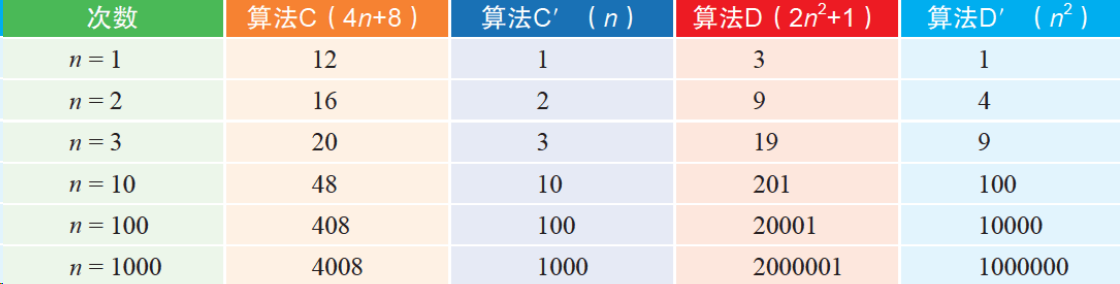
- 例2:我们进一步发现,哪怕去掉 n 的系数也无法影响结果,所以我们可以忽略 n 的系数。
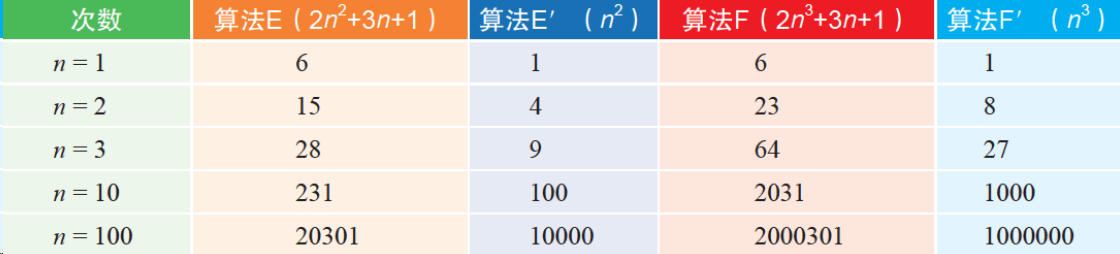
- 例3:只保留最高次项并忽略系数,仍可准确反映函数的渐进性。
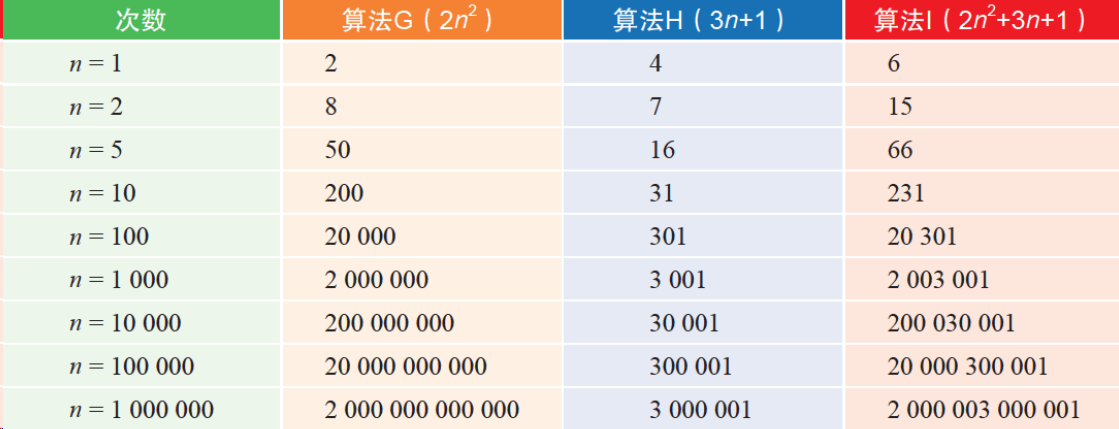
- 例4:分析一个算法的效率时,函数中的常数项、低次项及其系数均可被忽略,我们只通过最高次项的次数就可以判断函数的效率。
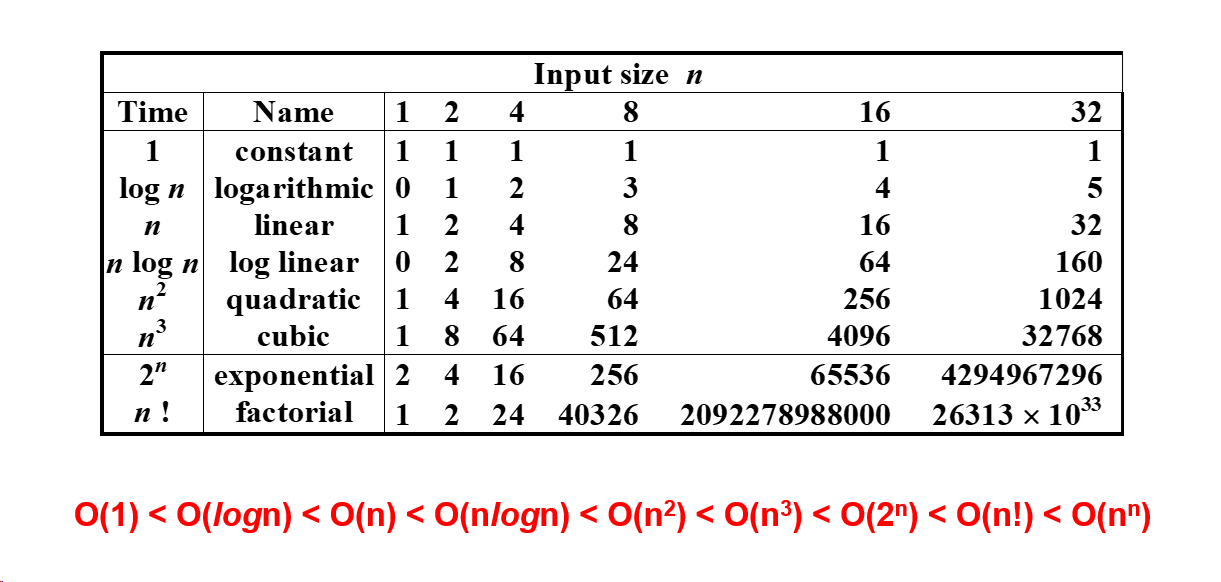
常见函数的渐进增长
二、渐进记号族
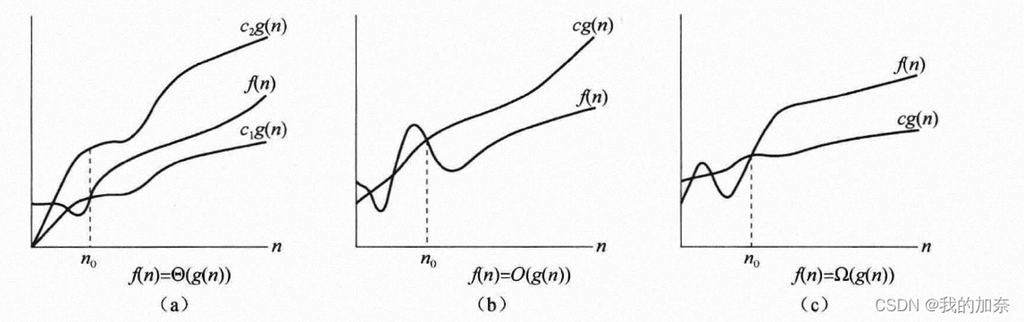
(1)渐进上界
- 定义:
- 当 N 足够大以后,T(N) 不会超过 f(N) 的某个常数倍;
- 例:
(2)渐进下界
- 定义:
- 当 N 足够大后,T(N) 至少有 g(N) 的某个常数倍那么大;
- 例:
(3)紧确界
- 定义:同时满足 和 ;
- T(N) 既不会比 h(N) 快太多,也不会比它慢太多(同阶);
- 例:
(4)严格渐进上界
- 定义: 且
- 必须严格低阶,不允许同阶;
- 例:
2.3.4 - 算法的时间复杂度
一、时间复杂度的定义
在进行事前分析时,算法中基本操作重复执行的次数,是问题规模 的某个函数 。算法的时间量度记作 。它表示随问题规模 的增大,算法执行时间的增长率和 的增长率相同,称为算法的渐进时间复杂度,简称时间复杂度。
- 这种时间复杂度的记法称为 大 O 记法(Big-O)。
- 一般情况下,随着 n 的增长,T(n) 增长最慢的算法是最优算法。
二、推导大 O 阶的方法
推导大 O 阶的步骤:
- 用常数 1 取代运行时间中所有的加法常数;
- 在修改后的运行次数函数中,只保留最高阶项;
- 如果最高阶项存在且系数不为 1,则令系数为 1。
大 O 阶的运算规则:
(两部分运行时间相加时,总复杂度由增长更快的那一项决定)
条件分支语句:
- 分支结构的运行时间不会超过测试条件的时间加上两个分支中最耗时者的运行时间,即
常见的大 O 阶及其算法例子:
(1)常数阶 O(1)
- 特点:算法的执行时间不随 n 的变化而变化,消耗恒定的时间。
- 例如:
// 例:直接访问数组元素
int getElement(int arr[], int i) {
    return arr[i];   // <--- 基本操作:只执行 1 次,与 n 无关
}

// 例:固定循环 100 次
for(int i = 0; i < 100; i++) {
    printf("Hello"); // 执行 100 次,但 100 是常量,记为 O(1)
}
(2)对数阶 O(logn)
- 特点:每次循环,数据规模都减半或大幅缩减。增长速度极慢,甚至在 n 为 1B 时也只需循环 30 次左右。
- 例如:
// 例子:二分查找的核心逻辑
int i = 1;
while (i < n) {
    i = i * 2;   // <--- 基本操作:每次翻倍
}
(3)线性阶 O(n)
- 特点:耗时与数据规模 n 完全成正比。数据量翻 k 倍,则耗时同样变为原来的 k 倍。
- 例如:
// 例子:查找数组中的最大值
int max = arr[0];
for (int i = 0; i < n; i++) {
    if (arr[i] > max) max = arr[i];   // <--- 基本操作:执行 n 次
}
(4)线性对数阶 O(nlogn)
- 特点:将问题拆分为 log n 层,每一层都遍历 n 个元素。这是最理想的通用排序算法可达到的效率,也是众多分治算法的最优效率。我们在之后会详细了解。
- 例子:
// 外层:step 以 2 的幂次增长,代表分治的层数 (执行 log n 次)
for (int step = 1; step < n; step *= 2) {
    // 内层:每一层都要从头到尾扫描整个数组 (执行 n 次)
    for (int i = 0; i < n; i++) {
        // 基本操作
        counter++;
    }
}
// 总次数:n * log2(n)
(5)平方阶 O(n²)
- 特点:循环的时间复杂度就是循环体的复杂度乘以循环的运行次数,倘若循环体的复杂度为 O(n),循环次数为 m,那么复杂度就为 O(m×n)。
- 例子:
n++;                       /* 执行次数为 1 */
function (n);              /* 执行次数为 n */
int i,j;
for (i = 0; i < n; i++)    /* 执行次数为 nxn */
{
    function (i);
}
for (i = 0; i < n; i++)    /* 执行次数为 n(n+1)/2 */
{
    for (j = i; j < n; j++)
    {
        /* 时间复杂度为 O(1) 的程序步骤序列 */
    }
}
这份代码的执行次数 ,根据推导大 O 阶的方法,其时间复杂度是 O(n²)。
(6)其他阶
- 立方阶 O(n³):三层嵌套循环。仅限于 n 很小(如矩阵乘法朴素的实现)时使用;
- 指数阶 O() 和 阶乘阶 O(n!):比如求斐波那契数列的暴力递归,或旅行商问题的暴力穷举,在实际程序中必须进行优化。
2.3.5 - 算法的空间复杂度
空间复杂度:算法在运行过程中临时占用存储空间的量度,记作 S(n) = O(f(n))。
其中 n 是问题的规模(如数据量、数组长度等),f(n) 是所需存储空间随 n 变化的函数。
- 空间复杂度与时间复杂度一样,并不考虑使用了多少空间,而是考虑随着问题规模 n 的增长,所需的空间随之增长的速度。
- 讨论空间复杂度,我们实际讨论的是辅助空间复杂度(Auxiliary Space Complexity),即算法为了完成计算而额外申请的空间。
| 复杂度 | 含义 | 典型场景 |
|---|---|---|
| O(1) | 常数空间,辅助空间不随 n 变化 | 简单变量、原地交换、迭代循环 |
| O(log n) | 对数空间 | 某些递归分治(如二分查找的递归栈深度) |
| O(n) | 线性空间 | 额外数组、哈希表、递归深度为 n(如线性递归) |
| O(n²) | 平方空间 | 二维矩阵、全对比较的辅助表 |
不带限定词使用“复杂度”时,通常指的是时间复杂度。
2.3.6 - 最坏情况与平均情况
即使输入规模 n 相同,因为具体输入数据的不同,算法实际执行的操作次数也可能不同,所以要考虑最好、最坏和平均的情况。
例如在一个长度为 n 的数组中查找一个数的算法:
- 最好的情况下,它就是数组的第一个数,时间复杂度就是 O(1);
- 最坏的情况下,它是最后一个数,时间复杂度为 O(n);
- 假设我们要找的数是第 k 个数时的时间成本为 k,且它出现在每个位置的概率都相同,那么平均时间复杂度就是:
没有特殊说明的情况下,时间复杂度指的是最坏情况下的时间复杂度。因为虽然平均运行时间是最有意义的,但是现实中很难通过分析得到。
2.4 - 计算时间复杂度实例
2.4.1 - 递归调用的时间复杂度
= 每次调用的自身开销 + 所有子调用产生的时间总和
关键方法:
- 递归树(Recursion Tree):把递归展开成树,统计每层工作量
- 主方法(Master Theorem):解形如 的递推式
- 代入法 / 迭代法(Iteration Method):手动展开找规律
一、方法一:递归树方法
步骤:
- 写出递推关系式,例如 ;
- 画出递归树,标注每层节点数与单节点代价;
- 计算每层总代价;
- 求所有层代价之和;
例如:
void fun(int n) {

    if (n <= 1)
        return;

    fun(n / 2);
    fun(n / 2);

    for (int i = 0; i < n; i++) {
        cout << "GFG ";
    }
}- 该函数:
- 进行两次递归调用,每次调用处理一个大小为
n/2的子问题 ; - 两次递归调用都返回后,它执行一个循环,该循环恰好打印
"GFG"n次,每次函数调用的计算量是线性的; - 当
n ≤ 1时,递归停止 。
- 进行两次递归调用,每次调用处理一个大小为
- 因此,递推关系为:,终止条件为 。
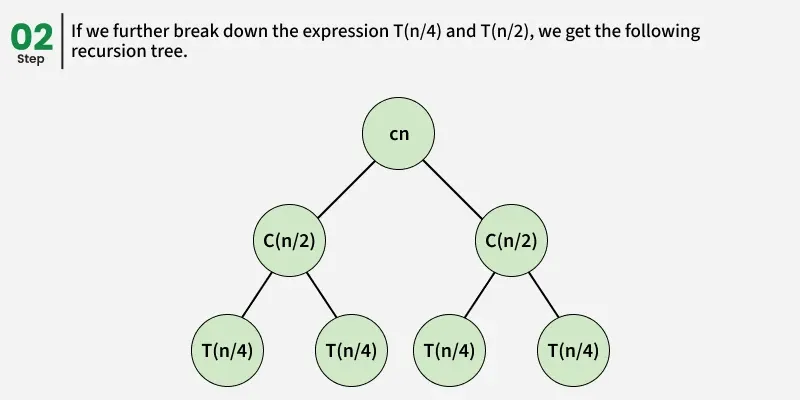
- level 0:总代价为 n;
- level 1:总代价为 ;
- level 2:总代价为 ;
- 可见每一层的总代价都为 n,所以我们只需要确定树的高度;
- 递归在 即 时停止,故树的高度为 ;
- 在递归树中,每一个结点代表一个函数调用,所以其实际上不包含叶子层的代价,所以在求和时需加上叶子层,即 ;
- 对于代价逐层递增的递归式,叶子层甚至会占据主导;
- 例如 ;
- 故总时间复杂度为 。
二、方法二:主方法
主方法用于快速解决递归式形如 的算法。
- 先计算 ;
- 然后比较 和 的增长速度。
| 情况 | 比较 | 谁占主导 | 结果 |
|---|---|---|---|
| Case 1 | 更小 | 递归部分 | |
| Case 2 | 两者相同 | 每层相当 | |
| Case 3 | 更大 | 非递归部分 |
三、方法三:迭代法
步骤:
- 写出递归式,如 ;
- 反复代入自身,;
- 找到第 k 次展开后的规律(不是必要步骤,规律和终点一眼能看出来,就直接展开;终点依赖指数、对数时,设 k 往往更方便,例如 );
- 确定终止条件(如 ),解出 与 的关系;
- 回代求和、化简。
例如:
int f(int n) {
    if (n == 1) return 1;
    int sum = 0;
    for (int i = 1; i <= n; i++)   // 本层循环 n 次 → Θ(n)
        sum += i;
    return f(n-1) + sum;           // 递归调用,规模 n-1
}- 这份代码的递归式是 ,终止条件为;
- 反复代入自身并展开,直到终止条件 n = 1:;
- 根据求和公式,得到 。
2.4.2 - 最长子序列问题的优化
一、Algorithm 1 - O(n3)
int MaxSubsequenceSum(const int A[], int N)
{
    int ThisSum, MaxSum, i, j, k;

    MaxSum = 0;  /* initialize the maximum sum */

    for (i = 0; i < N; i++)  /* start from A[i] */
    {
        for (j = i; j < N; j++)  /* end at A[j] */
        {
            ThisSum = 0;

            for (k = i; k <= j; k++)
                ThisSum += A[k];  /* sum from A[i] to A[j] */

            if (ThisSum > MaxSum)
                MaxSum = ThisSum;  /* update max sum */

        }  /* end for-j and for-i */
    }
    return MaxSum;
}- 外层
i确定子序列的起点; - 中层
j确定子序列的终点; - 内层
k从i循环到j,把所有元素加起来得到ThisSum。 - 如果
ThisSum > MaxSum,就更新MaxSum。
三层嵌套循环,每层都大致是 N 次,所以 。
二、Algorithm 2 - O(n2)
int MaxSubsequenceSum(const int A[], int N)
{
    int ThisSum, MaxSum, i, j;

    MaxSum = 0;  /* initialize the maximum sum */

    for(i=0; i<N; i++) {
        ThisSum = 0;

        for(j=i; j<N; j++) {
            ThisSum += A[j];  // 利用上一次的和,只加新元素
            if (ThisSum > MaxSum) MaxSum = ThisSum;
        }
    }
    return MaxSum;
}
Algorithm 1 在枚举终点 j 时,每次都在重复计算 A[i]...A[j] 的和,我们可以:
- 固定起点
i,初始化ThisSum = 0; - 让终点
j从i向后走,每走一步就ThisSum += A[j],边走边比较。
去掉了最内层的 k 循环,剩下两层嵌套循环,。
三、Algorithm 3 - 分治 - O(nlogn)
#include <stdio.h>

int max3(int a, int b, int c) {
    int m = a;
    if (b > m) m = b;
    if (c > m) m = c;
    return m;
}

/* 求跨越中间位置的最大子数组和 */
int MaxCrossingSum(const int A[], int left, int mid, int right)
{
    int leftSum = 0, sum = 0;
    int i;

    /* 从中点向左扫描,求以 mid 结尾的最大和 */
    for (i = mid; i >= left; i--)
    {
        sum += A[i];
        if (sum > leftSum)
            leftSum = sum;
    }

    int rightSum = 0;
    sum = 0;

    /* 从中点向右扫描,求以 mid+1 开始的最大和 */
    for (i = mid + 1; i <= right; i++)
    {
        sum += A[i];
        if (sum > rightSum)
            rightSum = sum;
    }

    return leftSum + rightSum;
}

/* 分治主函数 */
int MaxSubSumRec(const int A[], int left, int right)
{
    int mid;
    int maxLeftSum, maxRightSum, maxCrossSum;

    /* 递归基:只有一个元素 */
    if (left == right)
    {
        if (A[left] > 0)
            return A[left];
        else
            return 0;
    }

    mid = (left + right) / 2;

    /* 情况1:完全在左半边 */
    maxLeftSum = MaxSubSumRec(A, left, mid);
    /* 情况2:完全在右半边 */
    maxRightSum = MaxSubSumRec(A, mid + 1, right);
    /* 情况3:跨越中间 */
    maxCrossSum = MaxCrossingSum(A, left, mid, right);

    /* 三者取最大 */
    return max3(maxLeftSum, maxRightSum, maxCrossSum);
}

/* 对外接口 */
int MaxSubsequenceSum(const int A[], int N)
{
    return MaxSubSumRec(A, 0, N - 1);
}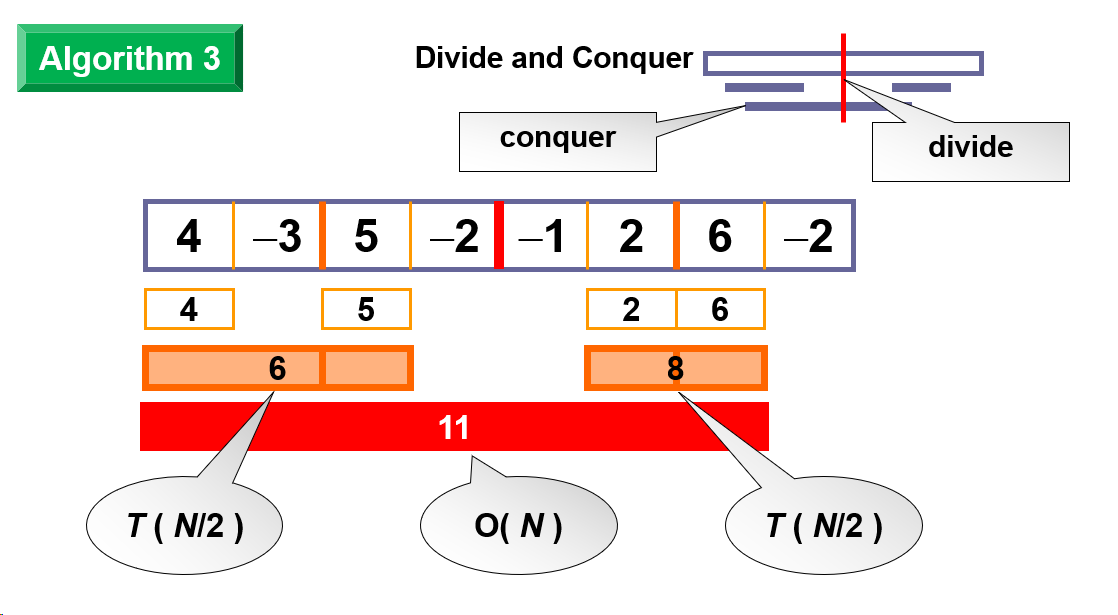
分治(Divide and Conquer)的思想:
- 把数组从中间(middle)一分为二,左边 L,右边 R。那么最大子序列和只可能出现在三个位置:
- 完全在左半边 L(递归求解 );
- 完全在右半边 R(递归求解 );
- 跨越中间,横跨左右两边(图3中红色横条的情况)。
- 跨中间的求法:
- 从中间向左扫描,求“以中间元素结尾”的最大和;
- 从中间向右扫描,求“以中间元素开始”的最大和;
- 两者相加,就是跨越中间的最大和。这部分只需要 O(N) 的时间。
递推公式:,且 。根据主定理,。
四、Algorithm 4 - Kadane算法 - O(n)
int MaxSubsequenceSum(const int A[], int N)
{
    int ThisSum, MaxSum, j;

    ThisSum = MaxSum = 0;

    for (j = 0; j < N; j++) {
        ThisSum += A[j];         // 累加当前元素

        if (ThisSum > MaxSum)    MaxSum = ThisSum;    // 发现更大的和,更新
        else if (ThisSum < 0)    ThisSum = 0;         // 和为负,抛弃,重新开始
    }

    return MaxSum;
}
核心思想:
- 如果前面累加出来的子序列和
ThisSum已经小于 0 了,那它一定不是最大子序列和,因为空子序列的和为 0,所以直接从 0 重新开始。
只扫描数组一次,。