[数据结构] 03 - 线性表
3.1 - 线性表抽象数据类型
回顾 - 抽象数据类型
[数据结构] 01 – 数据结构绪论(1.4.2 抽象数据类型 ADT)
3.1.1 - 定义
- 线性表(List)是 0 个或多个数据元素的有限序列;
- 线性表是每个元素都有唯一后继的列表;
A linear List is a list in which each element has a unique successor.
- 是 的后继,是 的前驱;
- 元素 的位置为 ,称为其位序;
- 元素个数 n 为线性表的长度,长度为 0 的列表称为空表。
3.1.2 - 线性表 ADT 定义
一、数据对象
回顾 - 数据对象
[数据结构] 01 – 数据结构绪论(1.2.4 数据对象)
线性表的数据对象是有限个同类型数据元素的集合,但这些元素在表中是有序的:
- 是某个数据元素集合,所有元素属于同一类型或同一数据对象集。
- 是线性表的长度。
- 当 时, 为空集,表示空表。
二、数据关系
线性表的数据关系通常表示为
- 若 ,则无数据关系,是空表。
- 若 :
- 是首元素,无直接前驱;
- 是尾元素,无直接后继;
- 对任意 , 是 的唯一直接前驱;
- 对任意 , 是 的唯一直接后继。
三、基本操作示例
*Operations are not fixed, and can be designed and implemented as you like.
| 操作 | 功能说明 | 操作结果 |
|---|---|---|
MakeEmpty(L) | 初始化操作 | 将线性表 L 置为空表 |
IsEmpty(L) | 判空操作 | 若 L 为空表返回 true,否则返回 false |
IsLast(P, L) | 判断位置 | 若位置 P 是 L 的最后一个元素位置,返回 true,否则返回 false |
Insert(X, L, P) | 插入操作 | 在 L 的位置 P 处插入元素 X,表长加 1 |
Delete(X, L) | 删除操作 | 删除 L 中值为 X 的元素,表长减 1 |
Find(X, L) | 查找操作 | 返回 L 中第一个值为 X 的元素的位置;若不存在,返回特定值(如 L.last + 1 或 NULL) |
Retrieve(P, L) | 取值操作 | 返回 L 中位置 P 处的元素值 |
FindPrevious(X, L) | 查找前驱 | 返回 L 中值为 X 的元素的前驱位置 |
3.1.3 - 分类(按逻辑结构)
一、一般线性表
一般线性表:对元素的插入、删除、访问位置不作额外限制的线性表;
General List: data can be inserted and deleted anywhere in the list.
- Array List(数组表)
- Linked List(链表)
- Cursor List(光标表)
- Doubly Linked List(双向链表)
- Circularly Linked List(循环链表)
二、受限线性表
*本文不讨论受限线性表
受限线性表:在一般线性表的基础上,对插入、删除、访问的位置或顺序施加限制的线性表;
Restricted List: data can be inserted or deleted at the ends of the list.
- Last-In-First-Out (Stack, 栈)
- First-In-First-Out (Queue, 队列****)
3.2 - 线性表的顺序存储结构
3.2.1 - 顺序存储结构
一、定义
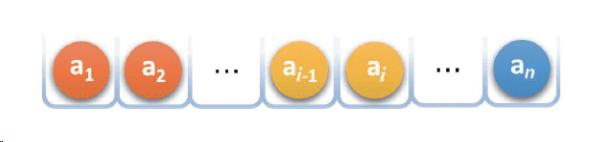
顺序存储结构:用一段地址连续的存储单元依次存储线性表的数据元素。
- 由于每个元素占用的存储空间大小相同,因此可以通过元素的下标(位置)直接计算出它的存储地址,从而实现随机存取。
二、存储方式
假设线性表有 n 个元素,每个元素占用 sizeof(ElemType) 个字节,第一个元素存放在地址 LOC(A) 处,那么第 i 个元素的地址为:
LOC(a_i) = LOC(a_1) + (i - 1) * sizeof(ElemType)即元素在内存中是挨着存放的,逻辑上相邻的元素在物理上也相邻。
3.2.2 - 顺序存储结构的表示
在 C 语言中,通常用数组来实现顺序表(数组表, Array List)。
一、静态列表
大小固定、不可扩容的数组表。
#define MAXSIZE 100        // 线性表的最大长度
typedef int ElemType;      // 假设元素类型为 int

typedef struct {
    ElemType data[MAXSIZE]; // 存放元素的数组
    int length;             // 当前线性表的长度
} SqList;
二、动态列表
- 增加
capacity记录当前能容纳多少元素,用于后续判断是否需要扩容; - 初始化时用
malloc分配空间,插入时若容量不足则用realloc扩容;- 主流的选择是进行 1.5 倍扩容(如 Java 的 ArrayList、MSVC 的
std::vector)或 2 倍扩容(部分 C++ 标准库实现中的std::vector)。
- 主流的选择是进行 1.5 倍扩容(如 Java 的 ArrayList、MSVC 的
#define INIT_SIZE 100
typedef int ElemType;

typedef struct {
    ElemType *data;   // 指向动态分配数组的指针
    int length;       // 当前长度
    int capacity;     // 当前容量
} SeqList;
3.2.3 - 实现基本操作
一、初始化
// 初始化顺序表:分配初始空间,长度置 0
bool InitList(SeqList *L) {
    // 申请 INIT_CAPACITY 个元素的连续空间
    L->data = (ElemType *)malloc(sizeof(ElemType) * INIT_CAPACITY);
    if (L->data == NULL) return false;   // 分配失败
    L->length = 0;                       // 当前有效元素个数为 0
    L->capacity = INIT_CAPACITY;         // 记录当前容量
    return true;
}
二、访问元素
// 取第 i 个元素(i 从 1 开始),用 *e 带回
bool GetElem(SeqList *L, int i, ElemType *e) {
    if (i < 1 || i > L->length) return false;  // 位置越界
    *e = L->data[i - 1];                       // 逻辑位置 i → 数组下标 i-1
    return true;
}
三、插入元素
// 在第 i 个位置插入 e(i 从 1 开始,可取 length+1 表示尾部插入)
bool ListInsert(SeqList *L, int i, ElemType e) {
    if (i < 1 || i > L->length + 1) return false;  // 位置非法

    // 容量不足时,扩容为原来的 2 倍
    if (L->length >= L->capacity) {
        int newCap = L->capacity * 2;
        ElemType *newData = (ElemType *)realloc(L->data, sizeof(ElemType) * newCap);

        if (newData == NULL) return false;   // 扩容失败

        L->data = newData;
        L->capacity = newCap;
    }

    // 从后往前,把第 i 个及之后的元素整体后移一位(必须从后往前,否则会覆盖)
    for (int j = L->length; j >= i; j--) {
        L->data[j] = L->data[j - 1];
    }
    L->data[i - 1] = e;   // 在空出的位置放入新元素
    L->length++;          // 长度加 1
    return true;
}
四、删除元素
// 删除第 i 个元素(i 从 1 开始),用 *e 带回被删的值
bool ListDelete(SeqList *L, int i, ElemType *e) {
    if (i < 1 || i > L->length) return false;  // 位置越界

    *e = L->data[i - 1];   // 先保存被删元素

    // 从前往后,把第 i+1 个及之后的元素整体前移一位(必须从前往后)
    for (int j = i; j < L->length; j++) {
        L->data[j - 1] = L->data[j];
    }
    L->length--;           // 长度减 1
    return true;
}
3.2.4 - 总结分析
一、时间复杂度
顺序存储的线性表(数组表)基本操作的时间复杂度:
| 插入场景 | 不需要扩容 | 正好需要扩容 | 综合(均摊) |
|---|---|---|---|
| 任意位置插入 | O(n) | O(n) | O(n) |
| 尾部插入 | O(1) | O(n) | O(1)(均摊) |
二、优缺点
优点:
- 支持随机访问:通过下标可在 O(1) 时间内访问任意元素。
- 存储密度高:只存数据本身,不需要额外的指针域,空间利用率高。
- 实现简单:用数组即可,逻辑清晰,易于理解和编写。
- 缓存友好:元素连续存放,CPU 缓存命中率高,遍历速度快。
缺点:
- 插入和删除效率低:平均需移动一半元素,时间复杂度 O(n)。
- 容量固定或扩容成本高:静态分配易溢出;动态分配扩容时需要重新申请空间并复制全部元素。
- 需要连续内存空间:当内存碎片较多时,可能无法分配足够大的连续空间。
- 空间可能浪费:预分配过大浪费内存。
3.3 - 线性表的链式存储结构
3.3.1 - 链式存储结构
一、定义
链式存储结构:通过一组任意的存储单元来存储线性表的数据元素。
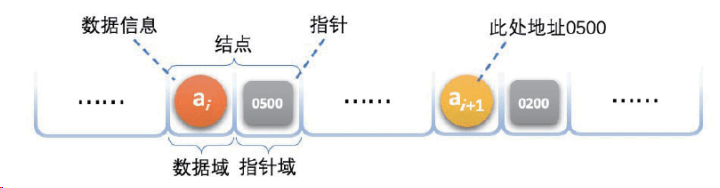
节点(Node): 链式存储的最小单位。一个节点通常包含两部分:
- 数据域(Data Field): 存储数据元素本身;
- 指针域(Pointer Field): 存储逻辑上相邻节点的内存地址(指针)。
二、术语
- 头指针(Head Pointer): 指向链表中第一个节点的指针;
- 尾指针(Tail Pointer): 指向最后一个节点的指针。
- 头结点(Dummy Head Node):在第一个实际数据节点之前附设的一个节点:
- 其数据域通常不存数据(或存链表长度),指针域指向第一个实际数据节点;
- 头结点的作用:统一空表和非空表的处理,简化插入和删除操作;
三、存储方式
因为长度不固定,链表的节点不能依靠栈来分配,必须使用堆(Heap)。
在新建结点时,使用 malloc 为其在堆内存中申请空间:
LNode *p = (LNode *)malloc(sizeof(LNode));在删除结点时,使用 free 释放其内存:
void free(void *ptr);3.3.2 - 单向链表
一、单向链表存储结构
typedef int ElemType;      // 假设为 int

// 单向链表结点结构
typedef struct LNode {
    ElemType data;         // 数据域:存放元素
    struct LNode *next;    // 指针域:指向下一个结点
} LNode, *LinkList, *position;
1. 结点结构 LNode
data:数据域,存放具体元素;next:指针域,指向同类型的下一个结点(注意这里必须用struct LNode *,不能用LNode *,因为在结构体定义内部该类型名尚未生效)。
2. 类型别名
LNode:表示一个结点;LinkList:表示一个指向结点的指针,通常用来表示整个链表(即头指针);position:同为指向结点的指针,目的是在稍后实现基本操作时提高代码的可读性。
二、实现基本操作
1. 初始化
初始化一个带头结点的空链表
// 参数:LinkList *L (即 LNode **L),二级指针,为了能修改头指针本身
int InitList(LinkList *L) {
    // 分配头结点
    *L = (LinkList)malloc(sizeof(LNode));
    if (*L == NULL) {
        return 0; // 内存分配失败
    }
    (*L)->next = NULL; // 头结点的 next 置空
    return 1; // 成功
}
头结点(header):
- 不存放有效数据,它的
next指向第一个真正的数据结点a1。 - 初始化就是创建一个头结点,并让它指向 NULL。
2. 访问和取回
查找元素 x 并返回其位置(结点指针)
// 参数:要查找的元素 x,链表的头结点 L
Position Find(ElemType x, LinkList L) {
    Position p = L->next; // 从头结点的下一个(第一个真实结点)开始找

    // 循环条件:p 不是空,且 p 指向的数据不等于 x
    while (p != NULL && p->data != x) {
        p = p->next; // 向后遍历
    }

    return p; // 找到了返回对应结点指针,没找到返回 NULL
}
3. 插入
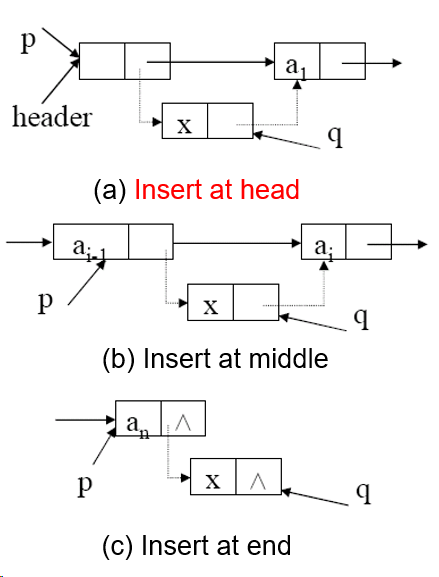
在指针 p 所指向的结点之后,插入元素 x
// 参数:ElemType x 要插入的元素;Position p 插入位置的前驱结点指针
int InsertAfter(ElemType x, Position p) {
    if (p == NULL) {
        return 0; // 插入位置不合法
    }

    // 1. 创建新结点
    Position q = (Position)malloc(sizeof(LNode));
    if (q == NULL) {
        return 0; // 内存分配失败
    }

    // 2. 赋值
    q->data = x;

    // 3. 修改指针(注意顺序,先连后面,再连前面)
    q->next = p->next; // 新结点的 next 指向 p 原本的下一个结点
    p->next = q;       // p 的 next 指向新结点 q

    return 1;
}
4. 删除
【代码一】删除指针 p 所指向的结点之后的下一个结点
// 参数:Position p 前驱结点指针;ElemType *e 用来返回被删除的元素值
int DeleteAfter(Position p, ElemType *e) {
    if (p == NULL || p->next == NULL) {
        return 0; // 前驱结点为空,或者后面没结点了,不能删
    }

    // 1. 记录要删除的结点
    Position q = p->next;

    // 2. 保存被删除的数据(可选)
    if (e != NULL) {
        *e = q -> data;
    }

    // 3. 跨过被删除的结点(断链)
    p->next = q -> next; // p 直接指向 q 的下一个结点

    // 4. 释放内存
    free(q);

    return 1;
}
【代码二】直接删除指针 p 所指向的结点:
- 把下一个结点的数据复制过来,然后删除下一个结点;
// 假设 p 是指向要删除结点的指针,且 p 不是尾结点
int DeleteNode(Position p) {
    if (p == NULL || p->next == NULL) {
        return 0; // 如果 p 是尾结点,这个方法就失效了(因为后面没结点了)
    }

    // 1. 记录 p 的后继结点 q
    Position q = p->next;

    // 2. 把 q 的数据复制到 p 中(覆盖掉原本要删除的数据)
    p->data = q->data;

    // 3. 把 p 的 next 指向 q 的 next(跳过 q)
    p->next = q->next;

    // 4. 释放 q(此时实际上被删除的是原来的 q,但数据被删掉了)
    free(q);

    return 1;
}
3.3.3 - 双向链表
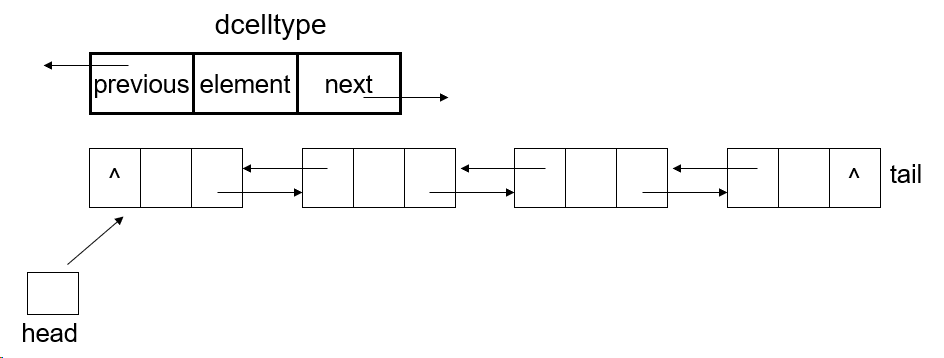
一、双向链表存储结构
typedef int ElemType;      // 假设为 int

// 双向链表结点结构
typedef struct DNode {
    ElemType data;         // 数据域:存放元素
    struct DNode *prior;   // 指针域:指向前驱结点
    struct DNode *next;    // 指针域:指向后继结点
} DNode, *DLinkList, *position;
二、基本操作的不同
插入操作
双向链表的插入操作需维护 4 个指针
// 在节点 p 之后插入元素 x
int InsertAfter(ElemType x, Position p) {
    if (p == NULL) {
        return 0; // 插入位置不合法
    }

    // 1. 创建新节点 q
    Position q = (Position)malloc(sizeof(DNode));
    if (q == NULL) {
        return 0; // 内存分配失败
    }

    // 2. 赋值
    q->data = x;

    // 3. 核心指针操作 (双向链表修改4个指针)
    q->next = p->next; // ① 新节点的后继,指向 p 原本的后继
    q->prior = p;      // ② 新节点的前驱,指向 p (这是单向链表没有的一步)

    if (p->next != NULL) { // ③ 如果 p 后面原本有节点,它的前驱要改为 q
        p->next->prior = q;
    }

    p->next = q;       // ④ p 的后继指向新节点 q

    return 1;
}
删除操作
双向列表在删除结点时,不需要在复制下一个节点的数据,并且可以处理删除尾节点的情况,但涉及到头结点的处理(若 p 是首元结点)
// 严谨版:删除节点 p,并支持删除首元节点
int DeleteNode(Position p, DLinkList *L) {
    if (p == NULL) return 0;

    // 1. 处理前驱
    if (p->prior != NULL) {
        p->prior->next = p->next;
    } else {
        // p 是首元节点,需要更新头指针 L 指向 p 的后继
        *L = p->next;
        if (*L != NULL) { // 注意:若链表只有一个真实节点,且被删除后,*L 会指向 NULL
            (*L)->prior = NULL;
        }
    }

    // 2. 处理后继
    if (p->next != NULL) {
        p->next->prior = p->prior;
    }

    // 3. 释放
    free(p);
    return 1;
}
3.3.4 - 循环单 / 双向链表
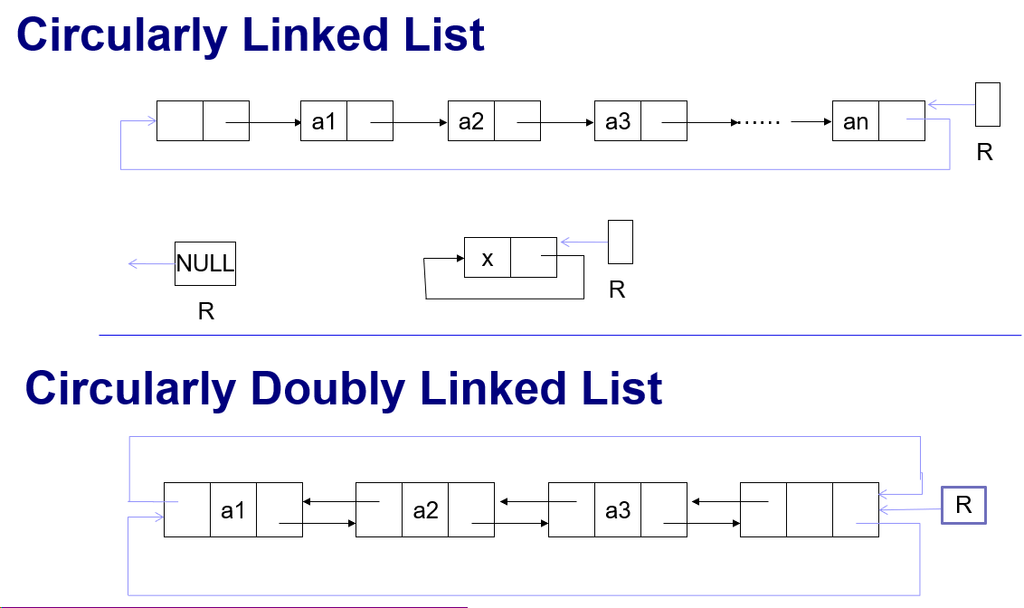
- 循环单向链表:尾节点的
next不再是NULL,而是指向头节点(或首元节点); - 循环双向链表:尾节点的
next指向头节点,头节点的prior也指向尾节点。
3.3.5 - 静态链表(光标表)
光标表(Cursor List):也叫静态链表,是在没有指针(Pointer)或者不允许使用动态内存分配(如 malloc)的环境下,用来模拟链表的一种数据结构。
一、光标表存储结构
光标表使用数组来存储数据,每个结点都存储其下一个结点的下标,用 -1 表示结尾
#define MAXSIZE 100 // 定义数组最大长度

typedef int elementtype; // 假设数据类型为int

typedef struct {
    elementtype element; // 数据域
    int next;            // 游标(相当于指针),存储下一个元素在数组中的下标
} spacestr;              // 节点类型

spacestr SPACE[MAXSIZE]; // 全局内存池(数组)
二、实现基本操作
1. 初始化
初始化时,将所有结点初始化到一个空链表 available 中
void InitSpace(spacestr SPACE[], int *available) {
    for (int i = 0; i < MAXSIZE - 1; i++) {
        SPACE[i].next = i + 1;
    }
    SPACE[MAXSIZE - 1].next = -1; // 最后一个节点的next为-1
    *available = 0; // available 指向第一个空闲节点
}
2. 分配结点
GetNode 的作用是从 available 链表中取出一个节点,作为该空间中的一个新链表的头结点
 int GetNode(spacestr SPACE[], int *available) {
    int p;
    if (*available == -1) {  // 没有空闲节点
        return -1;
    }
    p = *available;                 // 取出第一个空闲节点
    *available = SPACE[p].next;     // available 指向下一个空闲节点
    return p;                       // 返回分配的节点下标
}
3. 释放节点
将不再使用的节点 q 回收,插入到 available 链表的头部
// 传入 SPACE 数组、available 指针 和 要释放的节点索引 q
void FreeNode(spacestr SPACE[], int *available, int q) {
    SPACE[q].next = *available; // q 的 next 指向当前的空闲头
    *available = q;             // available 指向 q,q 成为新的空闲头
}
4. 插入操作
在第 p 个节点(p 为下标)后插入一个值为 x 的新节点
void INSERT(spacestr SPACE[], int *available, elementtype x, int p) {
    if (p < 0 || p >= MAXSIZE) {
        printf("插入位置非法\n");
        return;
    }

    int q = GetNode(SPACE, available); // 获取一个新节点
    if (q == -1) {
        printf("空间已满,无法插入\n");
        return;
    }

    SPACE[q].element = x;            // 存入数据
    SPACE[q].next = SPACE[p].next;   // 新节点的next指向p的下一个
    SPACE[p].next = q;               // p的next指向新节点
}
5. 删除操作
删除第 p 个节点之后的节点
void DELETE(spacestr SPACE[], int *available, int p) {
    if (p < 0 || p >= MAXSIZE) {
        printf("删除位置非法\n");
        return;
    }

    int q = SPACE[p].next; // q 是 p 后面的那个节点
    if (q != -1) {         // 如果 p 后面有节点
        SPACE[p].next = SPACE[q].next; // p 跳过 q 指向 q 的下一个
        FreeNode(SPACE, available, q); // 释放 q
    } else {
        printf("p 后面没有节点可删除\n");
    }
}
3.3.6 - 总结分析
以上五种链表的基本操作时间复杂度:
| 操作 | 单链表 | 双链表 | 循环单 | 循环双 | 光标表 |
|---|---|---|---|---|---|
| 按索引访问 | O(n) | O(n) | O(n) | O(n) | O(n) |
| 按值查找 | O(n) | O(n) | O(n) | O(n) | O(n) |
| 头部插入 | O(1) | O(1) | O(1) | O(1) | O(1) |
| 头部删除 | O(1) | O(1) | O(1) / O(n) | O(1) | O(1) |
| 已知结点后插入 | O(1) | O(1) | O(1) | O(1) | O(1) |
| 已知结点前插入 | O(n) | O(1) | O(n) | O(1) | O(n) |
| 删除已知结点本身 | O(n) | O(1) | O(n) | O(1) | O(n) |
| 尾部插入 | O(n) | O(1) | O(1) | O(1) | O(n) |
| 尾部删除 | O(n) | O(1) | O(n) | O(1) | O(n) |
| 遍历 | O(n) | O(n) | O(n) | O(n) | O(n) |
| 空间开销 | 较小 | 较大 | 较小 | 最大 | 固定数组空间 |
| 主要优点 | 简单 | 删除插入方便 | 可循环遍历 | 功能最强 | 无指针、数组模拟 |
| 主要缺点 | 找前驱难 | 多一个指针 | 尾操作有时麻烦 | 结构复杂 | 容量固定 |
3.4 - 反转 / 反向打印链表
3.4.1 - 逆置 / 反转链表(迭代法)
思路
我们要做的不是交换数据,而是对节点的链接关系进行调整:
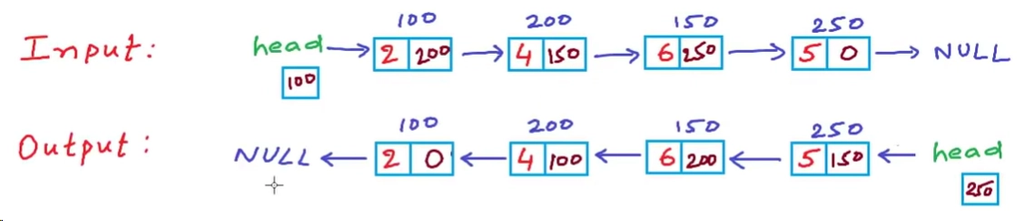
迭代法就是通过一个循环遍历整个链表,逐个调整每一个节点的链接关系。
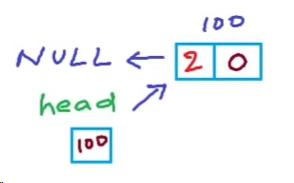
例如对于首节点,就让其 next 为 NULL,切断与第二个节点的链接
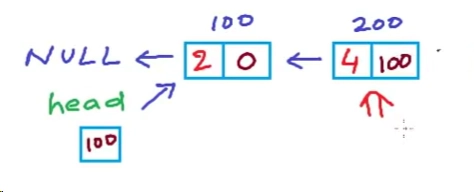
对于第二个节点,就是让其 next 为首节点的地址,切断与第三个节点的链接
重复这个过程直到尾节点,然后将 head 指向尾节点。
代码实现
void Reverse(Node* head) {
    Node *current, *prev, *next;
    current = head;
    prev = NULL;  // 首节点没有上一个节点,所以初始值为 NULL

    while (current != NULL) {
        next = current->next;  // 先记录当前节点的下一个节点
        current->next = prev;  // 将当前节点链接到上一个节点
        // 将 prev, current 整体向后移动一次
        prev = current;
        current = next;
    }
    // 最后,让 head 指向原本的尾节点,成为新的首节点
    head = prev;

    return head;
}
3.4.2 - 正 / 反向打印链表(递归法)
要将递归法正向打印的代码改为反向打印,不需要修改任何一行,只需要把递归放在打印之前就可以实现反向打印。
// 通过递归正向打印一个链表
Print(Node* p){
    if (P == NULL) return;  // 结束递归的条件
    printf("%d", p->data);  // 先打印当前节点的值
    Print(p->next);         // 再进行递归调用
}

// 通过递归反向打印一个链表
ReversePrint(Node* p){
    if (P == NULL) return;
    ReversePrint(p->next);
    printf("%d", p->data);
}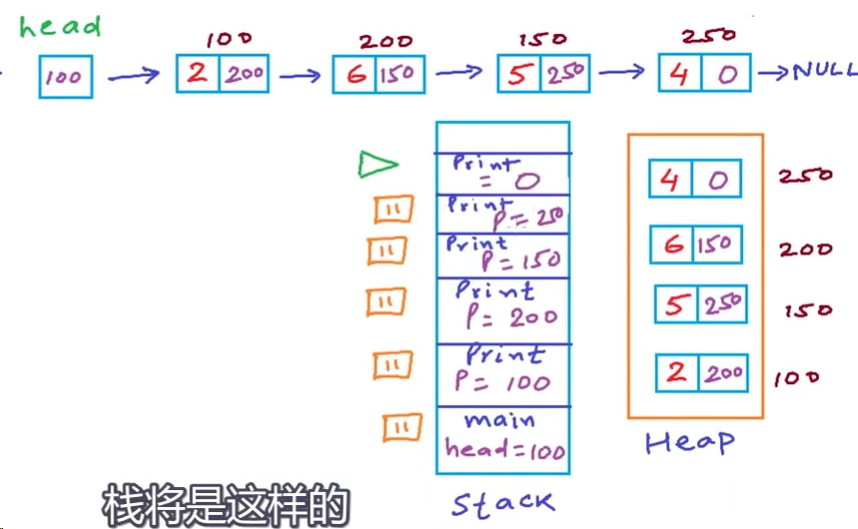
Stack 栈,Heap 堆
在递归时,Print 函数逐个入栈(图中 Stack,内存中的栈区),在进入新的 Print 函数时,旧的 Print 函数暂停。
- 直到最后一个 Print 函数入栈、遇到 return、出栈,
- 倒数第二个 Print 函数恢复、执行完毕后续代码 、出栈,
- 然后倒数第三个 Print 函数恢复、执行后续代码、出栈……
- 重复这个过程,直到最初的 Print 函数也执行完毕并出栈,这个递归就结束了。
也就是说对于 ReversePrint() 函数,在其从暂停状态恢复的时候,还要执行一行 printf 才可以出栈。导致最后打印的顺序反向。
有关 栈 的内容将在下一章介绍,但数据结构中的栈和内存中的栈不是一个概念,只是在数据关系上体现了同样的思想
https://salmon-isle.com/archives/2659
3.4.3 - 逆置 / 反转链表(递归法)
Reverse(Node* p) {
    // 退出条件
    // 达到退出条件,也就是 p 已经是原本的末尾节点
    // 所以我们要把 p 设置为新的首节点,然后退出函数
    if (p->next == NULL) {
        head = p;
        return;
    }
    Reverse(p->next);
    // 与刚才反向打印的例子一样,因为压栈
    // 这之后的内容也是以从末尾到首节点的反向顺序执行的
    Node* q = p->next;
    q->next = p;
    p->next = NULL;
}
最后三行所做的就是:
- 首先,获取 p 节点的后一个节点 q;
- 切断 q 节点原本的链接(q→next 原本应为 NULL),并将其链接到自己。也就是领 q 的下一个节点变成 p 节点;
- 令自己的下一个节点为 NULL(p 节点原本指向 q 节点,要断开这个链接)。
// 最后三行的另一种写法,更简洁
p->next->next = p;
p->next = NULL;