[数据结构] 04 - 1 - 栈和队列
栈和队列是操作受限的线性表。 它们属于线性表的范畴,但是是"受限"的线性表。
4.1 - 栈
一、定义
栈(Stack)是一个【后进先出(LIFO, Last In First Out)】的列表或者集合,它有这样一种限制:插入和删除操作只能从一端进行,称之为栈顶(Top)。
A stack is a Last-In-First-Out (LIFO) list, that is, an ordered list in which insertions and deletions are made at the top only.
最后加入的元素最先出去:就像一个球桶中的网球,最后被放进去的球,在取出时一定是最先被取出的,无法从中间的任意位置取出或插入一个球,除非先取出它上面的所有球
二、栈 ADT
(一)数据对象和数据关系
数据对象
- 记为 ,其中 ;
- 每个元素 可以是任意数据类型(如整数、字符、结构体等),具体取决于应用场景;
- 当 时,表示空栈。
数据关系
- 栈是一种线性结构,元素之间存在一对一的相邻关系。
- 可表示为:,即前驱与后继关系;
- 元素按 的顺序依次入栈,出栈时只能从 端进行。
- 通常 为栈底(Bottom)元素, 为栈顶(Top)元素;
(二)基本操作示例
| 操作名 | 含义 | 典型函数原型 |
|---|---|---|
| 初始化 | 构造一个空栈 | InitStack(&S) |
| 判空 | 判断栈是否为空 | IsEmpty(S) |
| 入栈 / 压栈(Push) | 在栈顶插入元素 | Push(&S, e) |
| 出栈 / 弹栈(Pop) | 删除栈顶元素并返回 | Pop(&S, &e) |
| 取栈顶 | 读取栈顶元素但不删除 | GetTop(S, &e) |
| 清空 | 将栈置为空栈 | ClearStack(&S) |
| 销毁 | 释放栈所占空间 | DestroyStack(&S) |
| 求长度 | 返回栈中元素个数 | StackLength(S) |
入栈、出栈、取栈顶和判空 4 个主要操作均为 O(1)。
三、实现基本操作(数组)
结构定义:
#define MAXSIZE 100          // 栈的最大容量
#define OK 1
#define ERROR 0

typedef int ElemType;        // 元素类型,可按需修改

typedef struct {
    ElemType data[MAXSIZE];  // 存放栈元素的数组
    int top;                 // 栈顶指针(下标),空栈时为 -1
} SqStack;
1. 初始化
void InitStack(SqStack *S) {
    S->top = -1;             // 栈顶指针置为 -1,表示空栈
}- 数组下标从 0 开始,入栈时先将栈顶加 1 再存入数据,所以从 -1 开始。
2. 入栈
必须考虑数组填满的情况,即发生溢出的情况:
- 在数组长度不足时,我们可以返回一个错误信息;
int Push(SqStack *S, ElemType e) {
    if (S->top == MAXSIZE - 1) {   // 栈满,上溢
        return ERROR;
    }
    S->data[++S->top] = e;         // 栈顶指针先加 1,再存入元素
    return OK;
}- 更好的做法是像动态数组那里讲的一样(3.2.2.2 动态列表),创建一个更大的数组,拷贝数据,然后删除旧数组。
3. 出栈
int Pop(SqStack *S, ElemType *e) {
    if (S->top == -1) {            // 栈空,下溢
        return ERROR;
    }
    *e = S->data[S->top--];        // 先取出栈顶元素,再让指针减 1
    return OK;
}
4. 取栈顶
int GetTop(SqStack *S, ElemType *e) {
    if (S->top == -1) {            // 栈空
        return ERROR;
    }
    *e = S->data[S->top];          // 只读取,不改变栈顶指针
    return OK;
}
四、实现基本操作(链表)
结构定义:
typedef int ElemType;

typedef struct StackNode {
    ElemType data;              // 数据域
    struct StackNode *next;     // 指针域
} StackNode, *LinkStack;
LinkStack 为指向栈顶结点的指针。空栈时 LinkStack == NULL。
1. 初始化
void InitStack(LinkStack *S) {
    *S = NULL;                  // 栈顶指针置空,表示空栈
}- 数组下标从 0 开始,入栈时先将栈顶加 1 再存入数据,所以从 -1 开始。
2. 入栈
int Push(LinkStack *S, ElemType e) {
    StackNode *p = (StackNode *)malloc(sizeof(StackNode));
    if (p == NULL) {            // 内存分配失败
        return ERROR;
    }
    p->data = e;
    p->next = *S;               // 新结点指向原栈顶
    *S = p;                     // 更新栈顶指针为新结点
    return OK;
}
3. 出栈
int Pop(LinkStack *S, ElemType *e) {
    if (*S == NULL) {           // 栈空
        return ERROR;
    }
    StackNode *p = *S;          // 暂存栈顶结点
    *e = p->data;               // 取出数据
    *S = p->next;               // 栈顶指针下移
    free(p);                    // 释放原栈顶结点
    return OK;
}
4. 取栈顶
int GetTop(LinkStack S, ElemType *e) {
    if (S == NULL) {            // 栈空
        return ERROR;
    }
    *e = S->data;               // 直接读取栈顶结点数据
    return OK;
}
五、栈的应用
参阅【4.1.5 - 栈的应用】
https://salmon-isle.com/archives/2663
这部分的内容较多,所以我将其独立为一篇文章,包括:
- 用栈的方法反转字符串 / 链表;
- 用栈检验括号匹配性(检测括号是否成对、是否未发生嵌套);
- 前缀、后缀、中缀表达式,及其之间的转换(用栈解决);
此外,栈还用于实现任何编辑器中的 Undo 操作。
六、总结
优缺点 / 复杂度:
- 栈的所有基本操作,时间复杂度均为 O(1)(除链式栈的清空);
- 顺序栈内存连续、实现简单,但容量较为固定,存在浪费 / 溢出问题;
- 链式栈不会溢出、容量只受限于内存,但需额外指针域、内存不连续、需要频繁的动态内存分配 / 释放。
4.2 - 队列
一、定义
队列(Queue)是一种先进先出(First In, First Out,FIFO)的列表或者集合,它有这样一种限制:只允许在队尾(rear) 插入,在队头(front) 删除。
A queue is a First-In-First-Out (FIFO) list, that is, an ordered list in which insertions take place at one end and deletions take place at the opposite end.
最先加入的元素最先出去:就和现实中的排队一样。
二、队列 ADT
(一)数据对象和数据关系
数据对象:与线性表一致;
数据关系:数据对象间仍是一对一的线性关系
a₁是队头元素,最先入队,也最先出队。aₙ是队尾元素,最后入队。- 新元素只能插在
aₙ之后(成为新的队尾)。 - 删除只能删
a₁(删后a₂成为新队头)。
(二)基本操作示例
| 操作名 | 含义 | 典型函数原型 |
|---|---|---|
| 初始化 | 构造一个空队列 | InitQueue(&Q) |
| 判空 | 判断队列是否为空 | QueueEmpty(Q) |
| 入队 (EnQueue) | 在队尾插入元素 | EnQueue(&Q, e) |
| 出队 (DeQueue) | 删除队头元素并返回 | DeQueue(&Q, &e) |
| 取队头 | 读取队头元素但不删除 | GetHead(Q, &e) |
| 清空 | 将队列置为空队列 | ClearQueue(&Q) |
| 销毁 | 释放队列所占空间 | DestroyQueue(&Q) |
| 求长度 | 返回队列中元素个数 | QueueLength(Q) |
三、实现(数组, 循环队列)
(一)假溢出问题
队列属于线性表,所以也有顺序和链式两种存储方式。如果采用顺序存储的方式:
- 入队操作只需在队尾追加元素,无需移动任何元素;
- 但是,出队操作要在队头删除元素,需要移动所有元素,使表首项不为空;
如果允许存在空元素?
- 可同时维护 head 和 rear 指针来标记队列的首尾位置,即可避免频繁、大量的元素移动;
- 但是,这会带来尾部超限,但头部仍有很多空元素的情况,造成假溢出。
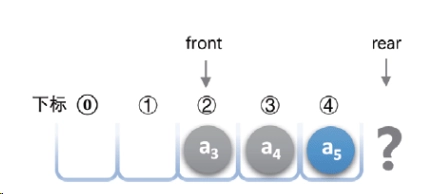
注:rear 指的是队列最后一个元素的下标 +1,这样方便判断空队列(当 front == rear 的时候,队列就为空)。并且队列的长度就是 rear - front。
(二)循环队列定义
- 解决假溢出的方法就是后面满了,就再从头开始,形成头尾相接的循环。
- 我们把队列这种头尾相接的顺序存储结构称为循环队列。
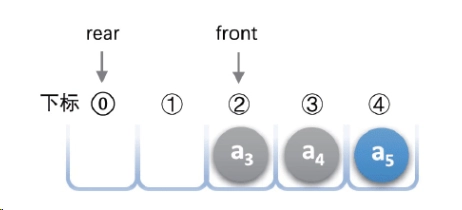
从刚才的例子继续:若 rear 超限,则移动到下标为 0 处从头开始
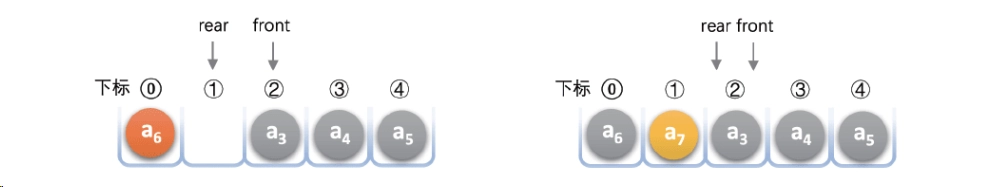
入队 a6 和 a7 后,rear 就与 head 指针重合
首尾指针重合,产生了新问题:如何判断此时的队列究竟是空还是满呢?
- 【办法一】设置标志变量 flag,为 true 时队列满,为 false 时队列空;
- 【办法二】当数组中只剩一个空闲单元时,就认为队列满了,即不允许右图的情况发生。即
(rear + 1) % QueueSize == front。
(三)循环队列实现
1. 存储结构定义
typedef int QElemType; // 假设为 int

typedef struct
{
    QElemType data[MAXSIZE];
    int front;
    int rear;
} SqQueue;
2. 初始化
Status InitQueue(SqQueue *Q)
{
    Q->front = 0;
    Q->rear = 0;
    return OK;
}
3. 求队列长度
int QueueLength(SqQueue Q)
{
    return (Q.rear - Q.front + MAXSIZE) % MAXSIZE;
}
同时解决了 rear 在 head 前、在 head 后两种情况。
4. 入队(EnQueue)
若队列未满,则插入元素 e 为 Q 新的队尾元素
Status EnQueue(SqQueue *Q, QElemType e)
{
    if ((Q->rear + 1) % MAXSIZE == Q->front)  // 判满
        return ERROR;

    // 将元素e赋值给队尾
    Q->data[Q->rear] = e;
    Q->rear = (Q->rear + 1) % MAXSIZE;
    return OK;
}
5. 出队(DeQueue)
若队列不空,则删除 Q 中队头元素,用 e 返回其值
Status DeQueue(SqQueue *Q, QElemType *e)
{
    if (Q->front == Q->rear)  // 判空
        return ERROR;

    // 将队头元素赋值给 e
    *e = Q->data[Q->front];
    Q->front = (Q->front + 1) % MAXSIZE;

    return OK;
}
四、实现(链表, 链式队列)
队列的链式存储结构,其实就是线性表的单链表,只不过它只能尾进头出而已,我们把它简称为链队列
1. 存储结构定义
typedef int QElemType;

typedef struct QNode      /* 结点结构 */
{
    QElemType data;
    struct QNode *next;
} QNode, *QueuePtr;       /* QueuePtr 是指向 QNode 的指针 */

typedef struct            /* 队列的链表结构 */
{
    QueuePtr front, rear;
} LinkQueue;
2. 初始化
初始化链队列:创建头结点,front 和 rear 都指向头结点
Status InitQueue(LinkQueue *Q)
{
    Q->front = Q->rear = (QueuePtr)malloc(sizeof(QNode));
    if (!Q->front)
        exit(OVERFLOW);

    // 头结点的 next 置空
    Q->front->next = NULL;

    return OK;
}
3. 入队
插入元素e为Q的新的队尾元素
Status EnQueue(LinkQueue *Q, QElemType e)
{
    QueuePtr s = (QueuePtr)malloc(sizeof(QNode));
    if (!s)
        exit(OVERFLOW);

    s->data = e;
    s->next = NULL;
    // 把拥有元素e的新结点s赋值给原队尾结点的后继
    Q->rear->next = s;

    Q->rear = s;
    return OK;
}
4. 出队
若队列不空,删除Q的队头元素,用e返回其值,并返回OK,否则返回ERROR
Status DeQueue(LinkQueue *Q, QElemType *e)
{
    QueuePtr p;
    if (Q->front == Q->rear)
        return ERROR;

    p = Q->front->next;
    *e = p->data;
    Q->front->next = p->next;

    // 若删空了,则将rear指向头结点,避免rear变成悬空指针
    if (Q->rear == p)
        Q->rear = Q->front;
    free(p);
    return OK;
}
五、总结
优缺点 / 复杂度:
- 无论循环还是链式队列,其基本操作都是 O(1) 的(除链式队列清空);
- 但循环队列只在开始申请空间,使用时不释放,时间开销会有细微的差异;
- 循环队列必须有固定的长度,而链队列则更加灵活。在可确定队列最大长度时,建议用循环队列。无法预估长度时,用链队列。