[数据结构] 05 - 串和 KMP 算法
以下是按要求处理后的文档内容:
5.1 - 串的定义和比较
5.1.1 - 串的定义
串(String)是由零个或多个字符组成的有限序列,又叫字符串;
- 串中的字符数目称为串的长度(lenth);
- 零个字符的串称为空串(nul string);
- 串的子序列称为子串(substring);
5.1.2 - 串的比较
在计算机中,字符串的比较通常遵循字典序(Lexicographical Order)。比较的本质是逐个字符比较其ASCII码值。
情况一:前缀关系(一个字符串是另一个的前缀)
条件: 且 (对于 )
- 例子:
- 前三个字母 "hap" 完全相同,但 更长,所以 。
情况二:字符差异(在某个位置出现了不同的字符)
条件: 存在某个位置 ,使得前面的字符都相同,但在第 个位置, 的字符小于 的字符(即 ASCII 码更小)。
- 例子:
- 前4个字符 "happ" 相同;
- 第5个字符: 是 'e', 是 'y'。
- 比较 ASCII 码:'e' (101) < 'y' (121)。
- 所以 。
5.2 - 串 ADT
5.2.1 - 数据对象和数据关系
- 串的数据对象是由字符组成的有限集合;
- 假设字符集为 ,那么串的数据对象就是 ( 上所有有限长度字符串的集合);
- 串是一种线性结构,相邻元素具有前驱和后继关系。
5.2.2 - 基本操作示例
| 操作 | 含义 | 函数名(参数) |
|---|---|---|
| 赋值 | 将字符串常量赋给变量 | StrAssign(&S, chars) |
| 求串长 | 返回串 的字符个数 | StrLength(S) |
| 串比较 | 比较两个串 | StrCompare(S, T) |
| 串连接 | 将串 连接到串 的末尾,生成新串 | Concat(&NewS, S, T) |
| 求子串 | 返回串中从第 个字符起、长度为 的子串 | SubString(&Sub, S, pos, len) |
| 串定位 | 若主串 中存在与串 相同的子串,返回它在主串中第一次出现的位置 | Index(S, T) |
| 清空串 | 将串 清空为空串 | ClearString(&S) |
| 判空 | 判断是否为空串 | StrEmpty(S) |
5.3 - 串的存储结构
5.3.1 - 顺序串(定长数组)
使用一组地址连续的存储单元来存储串的字符序列
#define MAXLEN 255  // 预定义最大串长为255
typedef struct {
    char ch[MAXLEN]; // 存储字符的数组,每个分量存一个字符
    int length;      // 串的实际长度
} SString;- 静态分配(存储在栈区内存),无法动态扩展;
- 随机访问:可通过下标 O(1) 访问任意字符;
- 空间浪费或溢出;
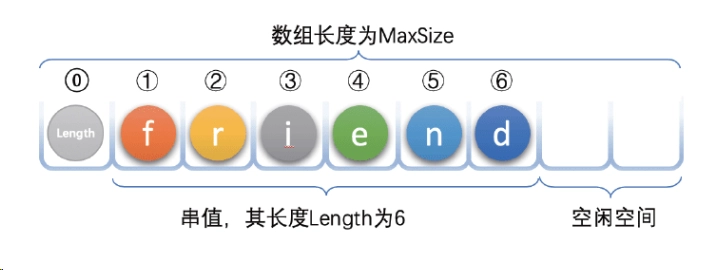
- 记录长度:通常会维护一个长度,不依赖
\0。也可以用字符串第 0 为记录长度。
5.3.2 - 顺序串(动态数组)
为了解决定长数组容易溢出和空间浪费的问题,采用动态内存分配
typedef struct {
    char *ch;    // 指向动态分配的内存首地址(而不是固定数组)
    int length;  // 串的实际长度
} HString;- 动态分配: 使用
malloc或 realloc 在堆内存中申请空间,方便扩容; - 随机访问:内存连续,所以仍支持随机访问;
5.3.3 - 块链串
采用链表的方式存储串。
- 因为串的字符通常很多,如果每个节点只存一个字符(像普通单链表那样),会导致存储密度极低(指针占用的空间远大于字符本身);
- 因此,块链串通常让每个节点存储多个字符(称为一个“块”)。
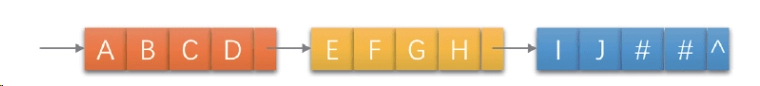
#define CHUNKSIZE 80 // 定义每个块的大小(节点中存放的字符个数)

typedef struct Chunk {
    char ch[CHUNKSIZE]; // 块内存储字符的数组
    struct Chunk *next; // 指向下一个块的指针
} Chunk;

typedef struct {
    Chunk *head, *tail; // 串的头指针和尾指针
    int length;         // 串的实际长度
} LString;- 链式存储: 内存不需要连续,通过指针链接各个块;
- 不支持随机访问;
- 适用场景: 适用于串非常长,经常需要进行插入、删除,而不常进行随机访问的场景。
5.5 - 模式匹配算法
一个字符串的子串定位操作称为【串的模式匹配(Pattern/String Matching)】
5.5.1 - 朴素模式匹配算法(BF 算法)
朴素模式匹配算法也叫暴力模式匹配算法(Naive Pattern Matching Algorithm / Brute-Force Algorithm, BF 算法),是更符合人的直觉的匹配算法。
一、思路
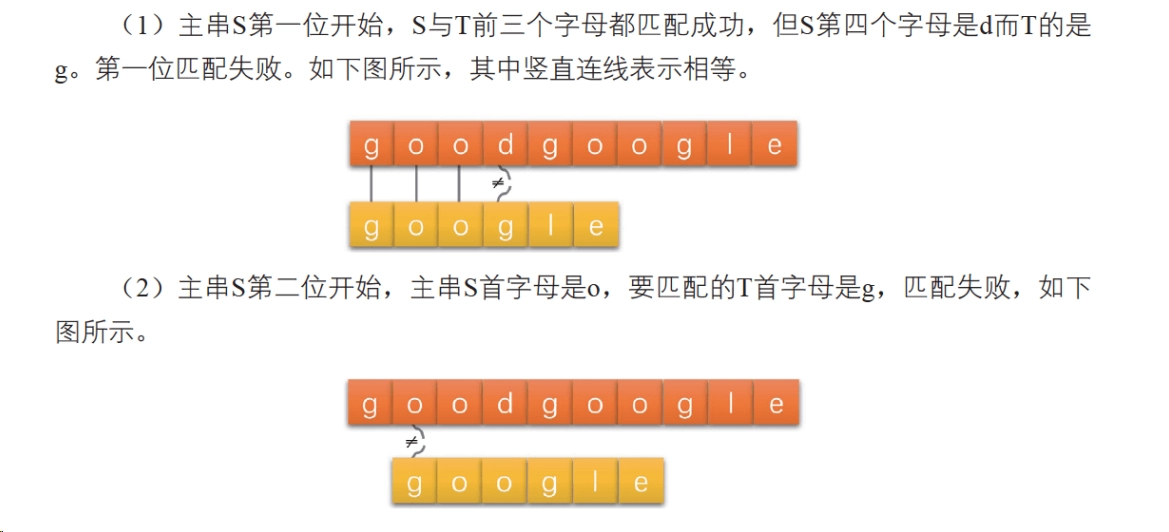
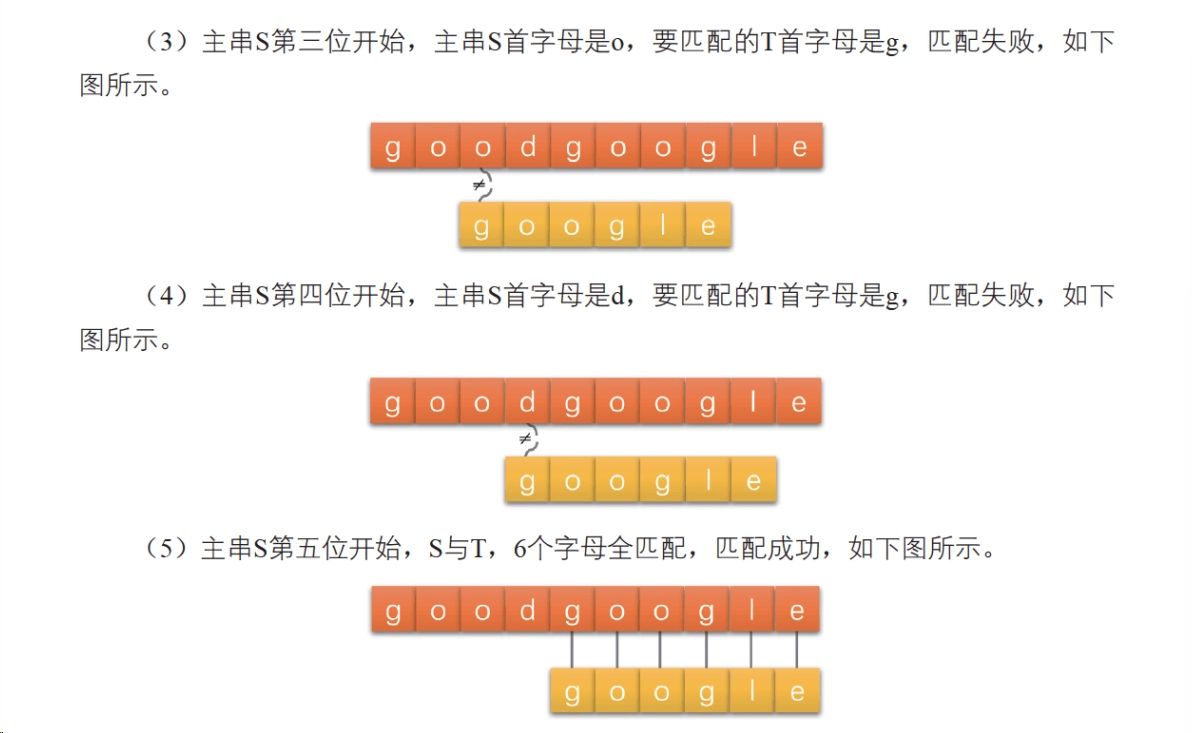
核心做法:主串和模式串从头开始比,一旦遇到不匹配的字符,主串指针回退(回溯)到本次匹配起点位置的下一个位置,模式串重新从头开始比。
例子:从主串 S = “goodgoogle” 中,找到子串 T = “google”
二、实现
C 语言(用字符串的第 0 位用来存储字符串的长度):
/* 返回子串T在主串S中第pos个字符之后的位置。若不存在,则函数返回值为0 */
/* 其中,T非空,1 <= pos <= StrLength(S) */
int Index(String S, String T, int pos)
{
    int i = pos;            /* i用于主串S中当前位置下标值,从pos位置开始匹配 */
    int j = 1;              /* j用于子串T中当前位置下标值 */
    while (i <= S[0] && j <= T[0])  /* 当i小于S的长度并且j小于T的长度时,循环继续 */
    {
        if (S[i] == T[j])   /* 两字母相等则继续 */
        {
            ++i;
            ++j;
        }
        else                /* 指针后退重新开始匹配 */
        {
            i = i - j + 2;  /* i退回到上次匹配首位的下一位 */
            j = 1;          /* j退回到子串T的首位 */
        }
    }
    if (j > T[0])
        return i - T[0];
    else
        return 0;
}j的值表示已经成功匹配了j - 1个字符;j > T[0]说明子串 T 的所有字符都已经匹配成功,匹配成功后循环就会退出。
三、复杂度分析
朴素模式匹配算法的时间复杂度,取决于主串 S 和子串 T 的字符分布情况:
- 最好情况: O(m),目标子串是串的前缀;
- 最坏情况: O(n × m),其中 n 是主串 S 的长度(例如主串为
"0000000001",子串为"0001",每次匹配都要到最后一位才失配并大幅回溯)。 - 平均情况:平均情况取决于字符集的大小:
- 自然语言文本字符种类多,第一位匹配成功的概率低,大部分不匹配在比较 1 个字符后就会发生,回溯距离很短,因此实际的运行效率接近 O(n + m);
- 二进制/高重复数据(极小字符集,例如 DNA 序列)中,字符种类很少,匹配失败后的回溯幅度通常较大,时间复杂度接近最坏情况 O(n × m)。
空间复杂度:
- O(1),仅需常数级的额外变量指针。
5.5.2 - KMP 模式匹配算法
D.E.Knuth、J.H.Morris 和 V.R.Pratt 研究了一个模式匹配法,可大幅避免重复遍历的情况,称为克努特-莫里斯-普拉特算法,简称 KMP 算法。
通过预分析模式串的结构,KMP 算法可将处理常规字符串的最坏时间复杂度从 O(n × m) 降低到 O(n + m)。
最浅显易懂的 KMP 算法讲解 - 哔哩哔哩
https://www.bilibili.com/video/BV1AY4y157yL
一、思路
核心思路:KMP 发现,主串指针不需要在失配后回溯。可以利用模式串已匹配的前缀信息,直接跳到一个合理的位置继续匹配。
- “合理的位置”将由 next 数组确定,计算 next 数组是 KMP 算法的核心;
- 也就是说,KMP 算法的核心思想就是主串指针 i 不回退,只移动串指针 j;而串指针 j 的回溯方式,由一个数组来决定。
【例子 1】主串 S = “abcdefgab...”,子串 T = “abcdex”
若使用朴素模式匹配法,需经历 6 步:
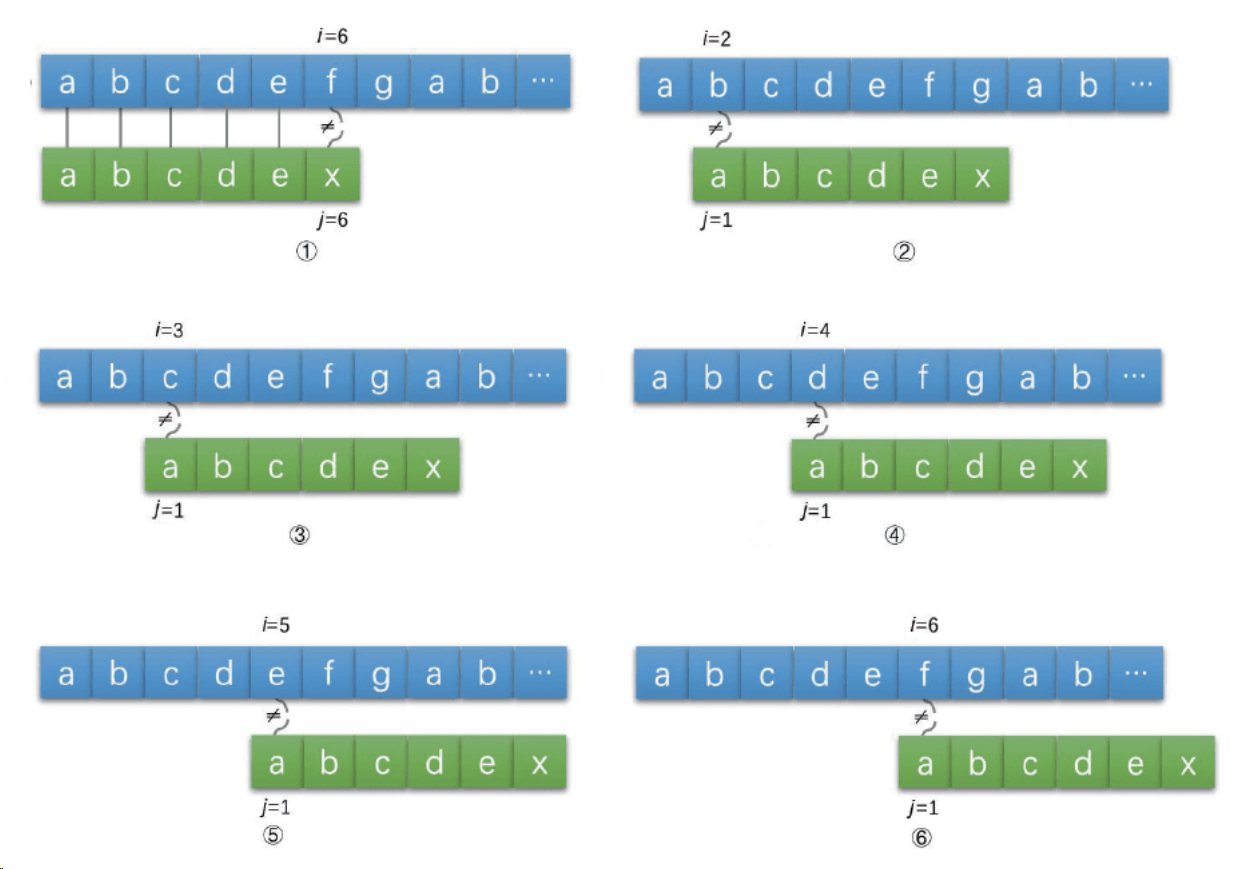
朴素模式匹配法的 6 个步骤
- 前 5 个字符时,两串完全相等(图中 ①);
- 到第 6 个字符时,出现不等,所以
i需回溯到主串的第 2 个字符,重新匹配; - 从
i = 2起,连续多次发生子串首字符('a')不匹配(图中 ②~⑤);
仔细观察可发现:
- 对于子串 T 来说,首字符
'a'与后续的"bcdex"都不一致; - 而在第一次比较时,
"bcde"与主串已经匹配,这说明 T 的首字符'a'不可能与主串的第 2 至 5 个字符一致; - 所以,步骤 ②~⑤ 都是多余的,可将子串 T 直接移动到与主串第 6 项(
'F')对齐,开始匹配。
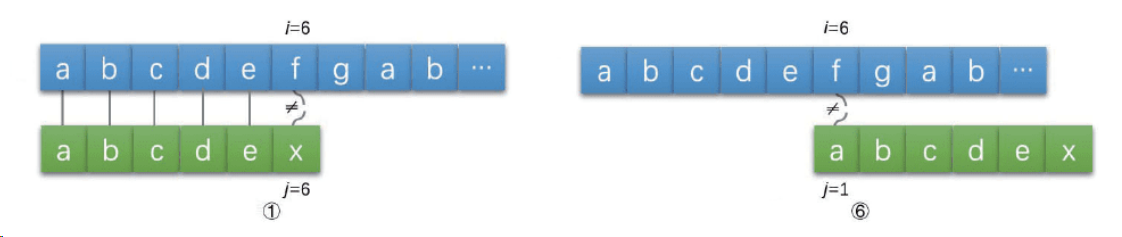
从第 ① 步,可直接跳到第 ⑥ 步
步骤 ⑥ 要保留,因为不能从 T[6] ≠ S[6] 得到 T[1] ≠ S[6]。
【例子 2】主串 S = “abcababca...”,子串 T = “abcabx”
如果子串 T 后面也出现了 'a' (也就是有重复的字符)怎么办?
若使用朴素模式匹配法,也需经历 6 步:
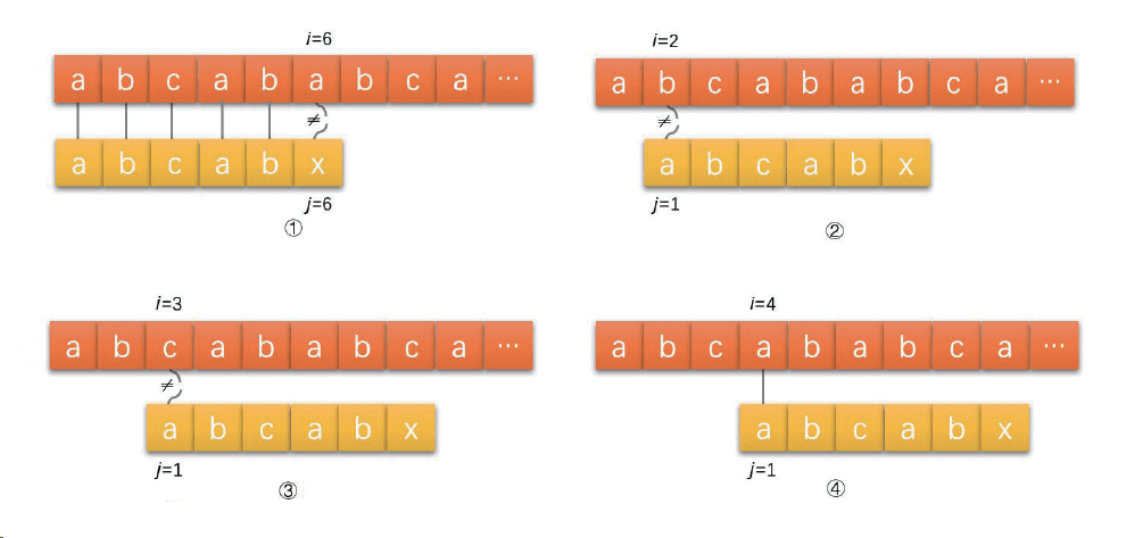
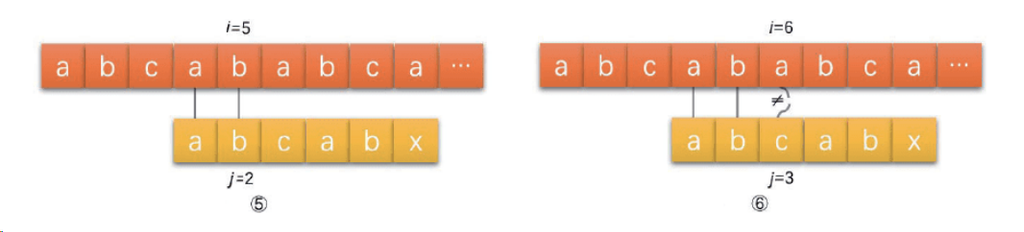
朴素模式匹配法的 6 个步骤
- 前 5 个字符时,两串完全相等(图中 ①);
- 第 6 个字符时发生不等,回溯;
- 根据刚才的经验,因为子串中
'a'和其后的"bc"不等,而 ① 中"bc"又与主串匹配,所以步骤 ②~③ 是多余的,可直接跳到步骤 ④;
而通过仔细观察可发现:
- 子串 T 的前缀是
"ab",其第 4~5 位也是"ab",而 ① 中"ab"也发生了匹配; - 我们可推断,子串 T 的前缀与主串 S 的第 4~5 位一定也匹配;
- 因此步骤 ④~⑤ 也是多余的,可直接跳到步骤 ⑥。
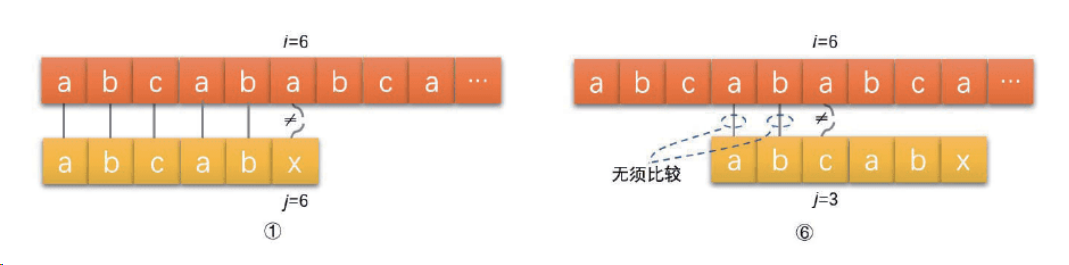
通过以上两个例子可发现:
- 主串上的指针
i确实不需要在失配后回溯; - 核心是合理地移动子串的指针
j(也就是回溯子串)。 - 而子串指针
j如何移动,取决于子串的结构,即子串字符重复的情况。
刚才的例子中:
- 【例子 1】T 在 x 前没有任何重复,
j从 6 变成 1; - 【例子 2】T 在 x 之前是
"abab",前缀和后缀有 2 位相等,j从 6 变成 3。
j 要回溯到的位置,好像与当前字符之前的串的前后缀相似度有关。也就是说,在模式匹配前,先对子串进行预分析,可使主串指针 i 在失配时无需回溯。
二、几种略有不同的 Next 数组定义
next 数组在不同的教材 / 视频中有很多不同定义,但其作用都一致:
next 数组:当模式串第 j 个字符发生失配时,子串要如何回溯。
并且,无论是哪种定义,它们要利用的信息,都是“最长的相同真前缀和真后缀”。(不等于整个串的前 / 后缀)
KMP 算法中的 next 数组主要有 3 种常见定义,此外还有一种优化版本 nextval。
以模式串 P = "ABABAC" 为例:
| 定义方式 | 下标起点 | next 数组 | 含义 |
|---|---|---|---|
| ① 考研 408 / 教材经典版 | 1 | [0, 1, 1, 2, 3, 4] | 失配时,模式串应跳转到的位置(从 1 开始编号) |
| ② -1 开头版 | 0 | [-1, 0, 0, 1, 2, 3] | 失配时,模式串应跳转到的位置(从 0 开始编号) |
| ③ 前缀长度版(LPS / π) | 0 | [0, 0, 1, 2, 3, 0] | 截至当前位置,最长相等真前后缀的长度 |
| ④ 优化版(nextval) | 1 | [0, 1, 0, 1, 0, 4] | 在①的基础上,跳过必然再次失配的位置 |
核心区别
| 定义方式 | 失配时如何更新模式串指针 j |
|---|---|
| ① 教材经典版 | j = next[j] |
| ② -1 开头版 | j = next[j],但需特殊处理 j == -1 |
| ③ LPS / π 版 | j = lps[j - 1],前提是 j > 0 |
| ④ nextval 优化版 | j = nextval[j] |
- ① 和②本质相同,主要区别是下标从 1 还是 0 开始。
- ③记录的是前后缀长度,而不是直接记录失配位置;因此使用时通常需要
j - 1。 - ④并不是独立的前后缀定义,而是对经典
next数组的优化。
三、实现 getNext() 函数
前缀长度版定义(LPS 定义)是比较直观、适合理解的一种 Next 数组定义方式,本文使用这种定义方式。
1. LPS 定义
LPS 定义的核心思想:对于模式串的每一个位置,计算截至该位置的子串中,最长相等真前缀与真后缀的长度。
对于 LPS 定义,**Next[j] = T[0 ... j] 的最长相等真前后缀长度**。
- 前缀:从字符串开头开始的连续子串。
- 后缀:到字符串末尾结束的连续子串。
- 真前缀、真后缀:不能是整个字符串本身,可以为空串。
2. 手算 Next 数组
以模式串 ABABCABAB 为例:
| i | 子串 (P[0 … i]) | 最长相等真前后缀 | Next[i] |
|---|---|---|---|
| 0 | A | 无 | 0 |
| 1 | AB | 无 | 0 |
| 2 | ABA | A | 1 |
| 3 | ABAB | AB | 2 |
| 4 | ABABC | 无 | 0 |
| 5 | ABABCA | A | 1 |
| 6 | ABABCAB | AB | 2 |
| 7 | ABABCABA | ABA | 3 |
| 8 | ABABCABAB | ABAB | 4 |
所以:Next = [0, 0, 1, 2, 0, 1, 2, 3, 4] 。
虽然结果正确,但这个过程存在问题:
- 每次都比较全部的前后缀,效率不高;
- 实际上,可利用已有的 Next 值,快速计算后面的值。
3. 递推求 Next 数组
在计算 Next[i] 时,我们一定已经算出 Next[i - 1]。
令 j = Next[i - 1],j 的含义就是在加入新字符 P[i] 之前,已经存在长度为 j 的相等真前后缀。
接下来只需比较 P[j] 和 P[i]:
CASE 1: P[j] == P[i]
如果 P[j] == P[i],则 Next[i] = j + 1;
- 因为
j表示已经比较过的相等真前后缀的长度,所以P[j]就是“已比较相同的前缀的下一个字符”(因为下标从 0 开始); - 如果
P[i](当前字符,也是原相同后缀的下一个字符)与P[j]相等,则说明原本的相同真前 / 后缀可延长一位; - 因此,令
Next[i] = j + 1,避免了重复的比较。
【例子】ABAB 再加一个 A
- 只需比较一次
P[2] == P[4],相等前后缀就可以从 AB 变成 ABA。
CASE 2: P[j] != P[i]
如果 P[i] != P[i],则尝试让 j = Next[j - 1];
然后重新比较,直到 P[j] == P[i] 或 j = 0;
- 如果
P[i]和P[j]不一样,说明最长的相等前后缀无法继续延长; - 但是,最长的相等前后缀无法继续扩展,不代表更短的相等前后缀也无法扩展,我们可以尝试在更短的前后缀的基础上延长;
- 而
Next[j-1]恰好能找到下一个值得尝试的长度(例子中说明原因) - 因此,令
j = Next[j - 1],并再次比较P[i]和P[j]; - 如果相等,则
next[i] = ++j,如果不等,则重复这个操作直到j = 0(j = 0时还要再比最后一次)。
【例子】ABAABA 再加一个 C
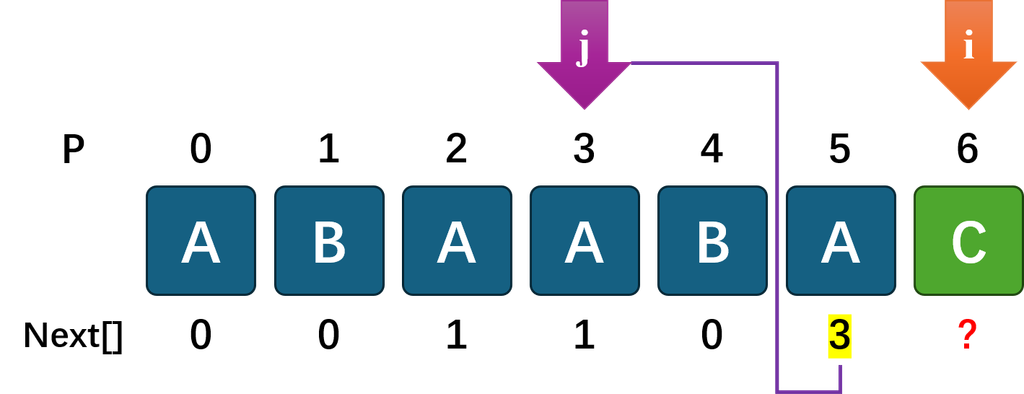
-
令
j = Next[i = 1] = 3,并比较P[i]和P[j](A 和 C),发现不等,也就是原本的最长相同真前后缀(ABA),无法继续延长;我们现在要寻找 ABAABA 这个字符串中,除了最长的 ABA 之外,第二长的相等真前后缀;
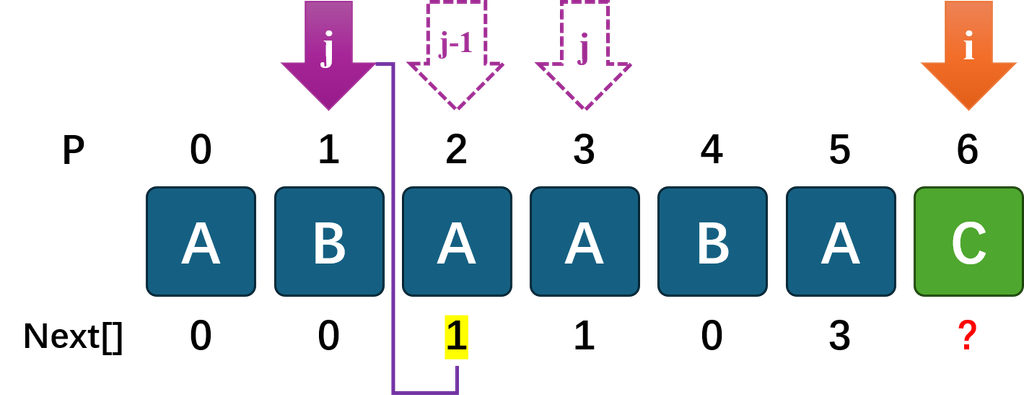
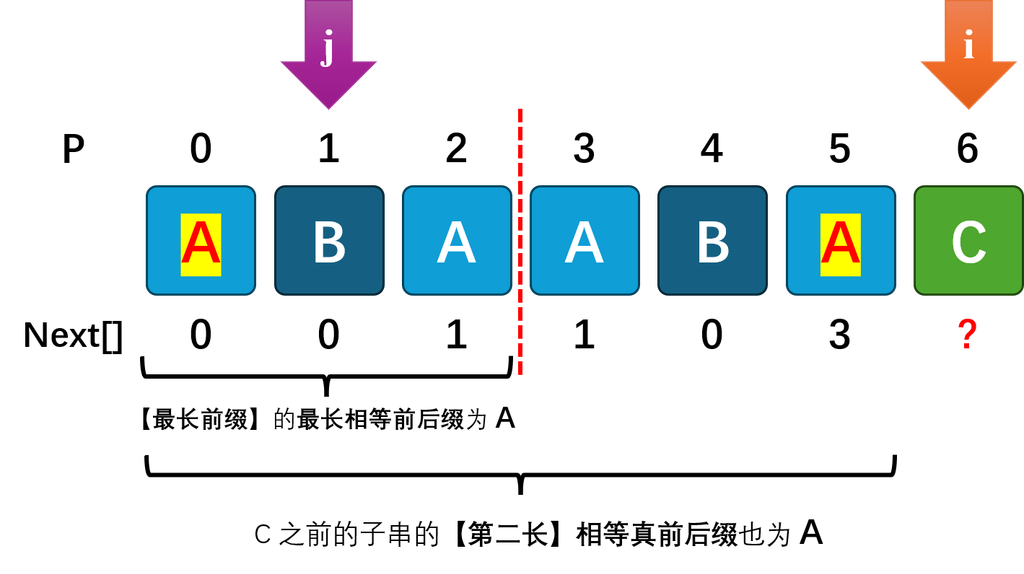
-
如图,令
j = Next[j - 1]。我们发现,Next[j - 1] 的值,就是“第二长的相等真前后缀”,也就是下一个值得进行比较的长度,因为“前缀的前缀”一定与“后缀的后缀”一致(图中红色 A);
-
再一次比较
P[i]和P[j](B 和 C),发现仍不等;
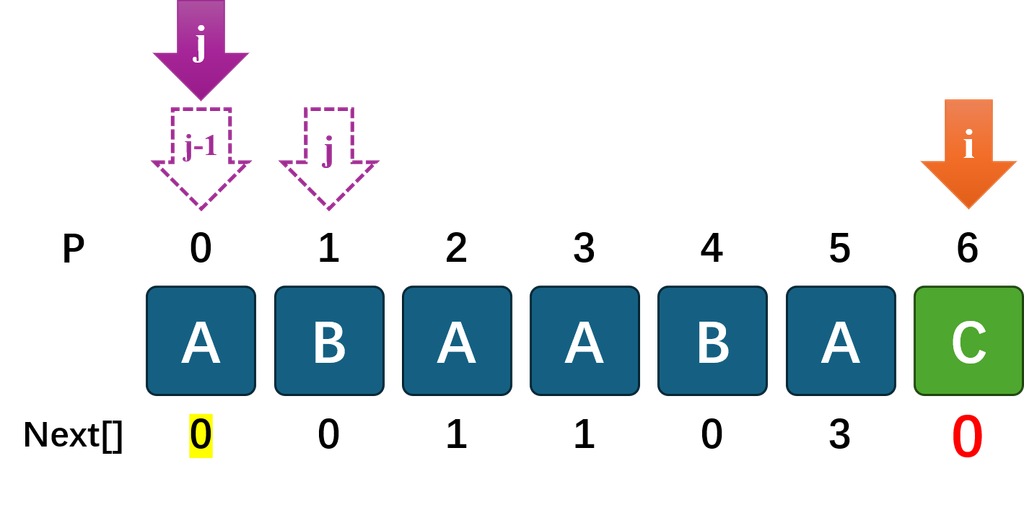
- 重复步骤,再一次令
j = Next[j - 1],此时j = 0(即终止条件); - 比较
P[i]和P[j](A 和 C),发现不等,因此Next[6] = 0;
4. 递推求 Next 数组的代码实现
用上述方法求 LPS 定义的 Next 数组(C 语言):
#include <stdio.h>
#include <string.h>

void getNext(const char P[], int Next[]) {
    int m = strlen(P);
    int j = 0;

    if (m == 0) return;

    // 首个字符的 next 值为 0
    Next[0] = 0;

    for (int i = 1; i < m; i++) {
        while (j > 0 && P[i] != P[j]) {
            j = Next[j - 1];
        }

        // j = 0 是终止条件,达到此条件后仍需再进行一次判断
        if (P[i] == P[j]) {
            j++;
        }

        Next[i] = j;
    }
}
这份代码如何保证每次进入 for 循环时,j 的值都是 Next[i-1] ?
j 在每次 for 循环结束时,都等于当前计算出来的 Next[i],而下一次循环开始时 i++,且 j 不会被重新初始化,自然就有 j = Next[i - 1]。
四、实现完整 KMP 代码
#include <stdio.h>
#include <string.h>

// 构造 Next 数组
void getNext(const char P[], int Next[]) {
    ...
}

// KMP 字符串匹配,T 为主串,P 为待匹配子串
int KMP(const char T[], const char P[]) {
    int n = strlen(T);
    int m = strlen(P);

    if (m == 0) return 0;

    int Next[m];
    getNext(P, Next);

    int j = 0;

    for (int i = 0; i < n; i++) {
        while (j > 0 && T[i] != P[j]) {
            j = Next[j - 1];
        }

        if (T[i] == P[j]) {
            j++;
        }

        if (j == m) {
            return i - m + 1;
        }
    }
    // 没有找到
    return -1;
}

int main() {
    char T[] = "ABABCABCACBAB";
    char P[] = "ABCAC";

    int pos = KMP(T, P);

    if (pos != -1) {
        printf("匹配成功,起始下标:%d\n", pos);
    } else {
        printf("匹配失败\n");
    }

    return 0;
}
可以发现 getNext() 和 KMP() 的核心结构几乎完全一样:
| 操作 | getNext() | KMP() |
|---|---|---|
| 比较字符 | P[i] 与 P[j] | T[i] 与 P[j] |
| 匹配失败 | j = Next[j-1] | j = Next[j-1] |
| 匹配成功 | j++ | j++ |
| 最终操作 | Next[i] = j | j == m 时,返回位置 |
因为两者实际上都在做同一件事:利用已经匹配的前缀信息,在失配时寻找下一个可能匹配的位置。
while (j > 0 && T[i] != P[j]) {
    j = Next[j - 1];
}
此时 j 表示模式串 P 中已经成功匹配的字符数量,因为每匹配成功一个字符 j 向前移动一位。
发生失配后:
- 主串下标
i不回退; - 模式串通过更新
j,尝试更短的已匹配前缀; - 通过循环,最终
j会更新为可以继续匹配的位置,或j = 0。