[数据结构] 06 - 1 - 树和二叉树
6.1 - 树
一、树的基础知识
(一)树的定义
树(Tree)是 n (n ≥ 0) 个节点的有限集。
树可以为空,n = 0 的树称为空树。
在任意一棵非空树中:
- 有且仅有一个特定的称为根(Root)的节点;
- 当 n > 1 时,其余节点可分为 m (m > 0) 个互不相交的有限集 T1 …… Tn,其中每一个集合本身又是一棵树,被称为根的子树(SubTree)。
(二)树的结点
1. 结点的度
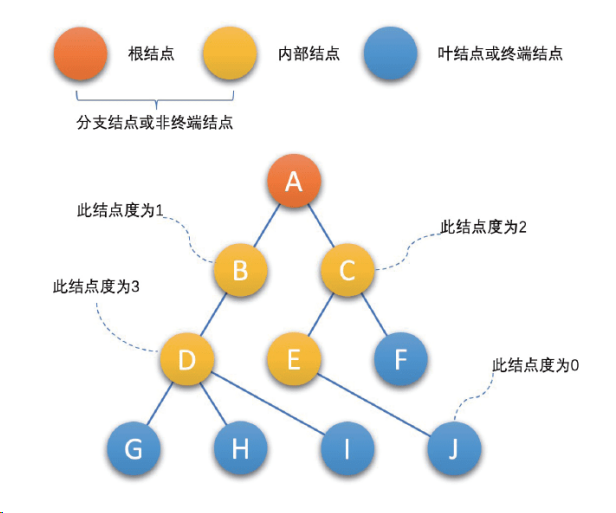
结点拥有的子树数量称为结点的度(Degree)。
2. 结点的分类(根据度分)
- 度为 0 的结点:称为叶结点(Leaf)或终端结点;
- 度不为 0 的结点:称为非终端结点或分支结点。
- 除根节点外的分支结点,也称为内部结点;
- 树的度是树内各结点的度的最大值。
(三)树的结点的关系
1. 关于树中层次、高度等的描述
- 层次(Level):从根开始,根为第 1 层,根的子结点为第 2 层,依此类推;
- 深度(Depth):通常指从根结点到某结点的路径长度或层数;
- 高度(Height):通常指从某结点到其最远叶子结点的最长路径长度或层数;
- 路径(Path):从一个结点到另一个结点所经过的结点序列;
- 路径长度(Path Length):路径上经过的边数。
2.结点的关系
- 孩子(Child):某结点的子树是该节点的孩子;
- 双亲(Parent):B 树是 A 结点的子树,A 是 B 的双亲;
- 兄弟(Sibling):同一个双亲结点的子结点;
- 祖先(Ancestor):从根到该结点所经分支上的所有结点;
- 子孙(Descendent):以某结点为根的子树中的任一结点。
(四)树的分类
- 有序树(Ordered Tree):子树有先后次序,不可随意调换;
- 无序树(Unordered Tree):子树之间无顺序关系,交换后仍是同一棵树;
- 森林(Forest):m 棵互不相交的树的集合。一棵树去掉根节点后,其子树的集合就是一个森林。
二、树 ADT
(一)数据对象和数据关系
数据对象:
- 元素类型:由 n 个节点(Node)组成,每个节点包含一个数据元素(或称为值)和若干指向其子树的指针;
- n = 0 时,称为空树,数据对象为空集;
- n > 0 时,数据对象中存在唯一的根节点,无前驱。
数据关系:
树是一种层次结构,节点之间存在“一对多”的关系。
- 每个节点(除根节点外)有且仅有一个前驱(双亲节点),但可以有 0 个或多个后继(子节点);
(二)基本操作示例
树的基本操作示例表
| 典型函数定义 | 操作中文名 | 操作简单描述 |
|---|---|---|
isEmpty(T) | 判空操作 | 判断树 T 是否为空树 |
getRoot(T) | 取根节点 | 返回树 T 的根节点(空树时返回空/异常) |
getParent(T, v) | 取父节点(双亲节点) | 返回节点 v 的父节点(根节点无父节点) |
getFirstChild(T, v) | 取第一个孩子 | 返回节点 v 的第一个子节点 |
getNextSibling(T, v) | 取下一个兄弟 | 返回节点 v 的下一个兄弟节点 |
getChild(T, v, i) | 取第 i 个孩子 | 返回节点 v 的第 i 个子节点 |
getDegree(T, v) | 取节点度 | 返回节点 v 的子节点个数 |
getDepth(T) | 求树深度 | 返回树 T 的最大层次数(深度/高度) |
getNodeCount(T) | 求节点数 | 返回树 T 中节点的总数 |
getLeafCount(T) | 求叶子数 | 返回树 T 中叶子节点的个数 |
locate(T, e) | 查找节点 | 查找数据元素为 e 的节点并返回其位置/引用 |
insertChild(T, v, i, c) | 插入子树 | 将子树 c 插入为节点 v 的第 i 个孩子 |
deleteChild(T, v, i) | 删除子树 | 删除节点 v 的第 i 个孩子及其子树 |
traverse(T, visit) | 遍历操作 | 按某种次序(先序/后序/层次等)访问树中所有节点 |
preOrder(T, visit) | 先序遍历 | 先访问根,再依次先序遍历各子树 |
postOrder(T, visit) | 后序遍历 | 先依次后序遍历各子树,再访问根 |
levelOrder(T, visit) | 层次遍历 | 按层次从上到下、从左到右访问节点 |
clear(T) | 清空操作 | 删除树中所有节点,使 T 变为空树 |
destroy(T) | 销毁操作 | 释放树 T 占用的全部存储空间 |
树和线性表不同,所以遍历方式有很多,将在 06-2 中介绍。
三、树的存储
树有三种主要的表示方法:
| 表示法 | 核心思想 | 逻辑存储结构 | 优点 | 缺点 |
| 双亲表示法 | 记录双亲结点的数组下标。 | 连续数组(包含 data 和 parent 字段)。 | 寻找双亲极快 | 寻找结点的孩子需要遍历整个数组。 |
| 孩子表示法 | 数组存结点,每个结点附带一个单链表记录其所有孩子。 | 结构体数组 + 孩子结点单链表。 | 寻找所有孩子非常方便 | 寻找结点的双亲比较麻烦,需要遍历全树的所有链表。 |
| 孩子兄弟表示法 | 两个指针,分别指向第一个孩子和下一个右兄弟。 | 二叉链表(包含 data、firstchild、rightsibling)。 | 将任意普通树转换为了二叉树,利于复用二叉树的操作算法 | 找结点的双亲不够直接(可额外增加 parent 指针优化)。 |
(一)双亲表示法
用一组连续空间(数组)存储结点,每个结点中附带一个指示其双亲结点在数组中下标的字段。根结点的双亲下标设为 -1。
#define MAX_TREE_SIZE 100
typedef int ElemType;

typedef struct {
    ElemType data;      // 数据元素
    int parent;         // 双亲位置下标(根为 -1)
} PTNode;

typedef struct {
    PTNode nodes[MAX_TREE_SIZE];  // 结点数组
    int n;                        // 结点数
} PTree;
例子:用双亲表示法表示一个树结构
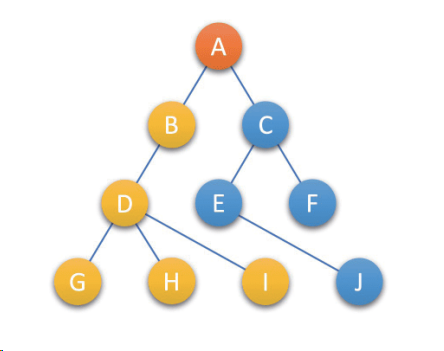
| 下标 | data | parent |
|---|---|---|
| 0 | A | -1 |
| 1 | B | 0 |
| 2 | C | 0 |
| 3 | D | 1 |
| 4 | E | 2 |
| 5 | F | 2 |
| 6 | G | 3 |
| 7 | H | 3 |
| 8 | I | 3 |
| 9 | J | 4 |
优缺点:
- 优点:可快速找某个结点的双亲结点,同时为 O(1);
- 缺点:找孩子结点,必须遍历整个数组。
(二)孩子表示法
把每个结点的孩子结点排列起来,看成线性表,用单链表存储;n 个结点有 n 个孩子链表;再用一个数组存放每个结点的头指针(和数据)。
#define MAX_TREE_SIZE 100
typedef int ElemType;

// 孩子链表中的结点
typedef struct CNode {
    int child;              // 孩子结点在表头数组中的下标
    struct CNode *next;     // 指向下一个孩子
} CNode;

// 表头数组的元素
typedef struct {
    ElemType data;          // 数据元素
    CNode *firstchild;      // 孩子链表头指针
} CTBox;

typedef struct {
    CTBox nodes[MAX_TREE_SIZE];  // 表头数组
    int n;                       // 结点数
} CTree;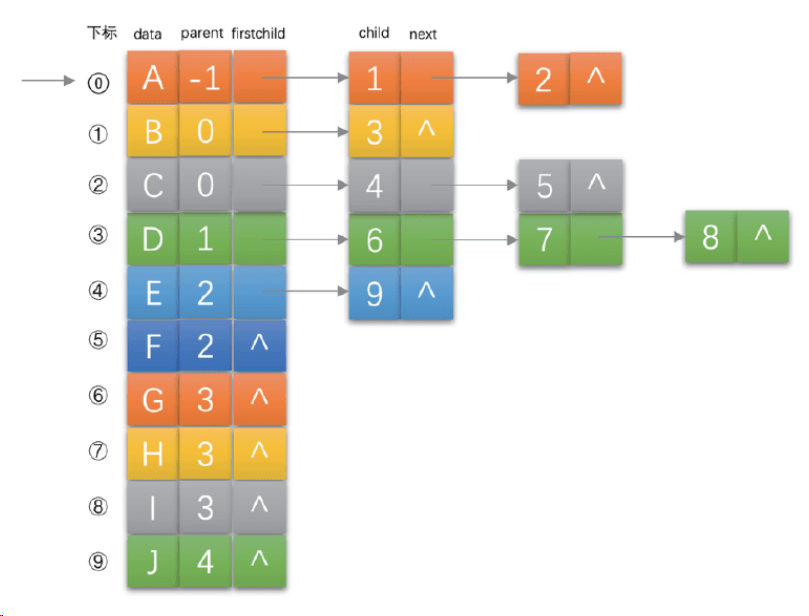
包含双亲数据的孩子表示法
特点:
- 找孩子很方便(沿着孩子链表遍历)。
- 找双亲不方便,需要遍历所有孩子链表。
- 可以在此基础上再加一个
parent字段,变成"双亲孩子表示法",兼顾两者。
(三)孩子兄弟表示法(二叉链表表示法)
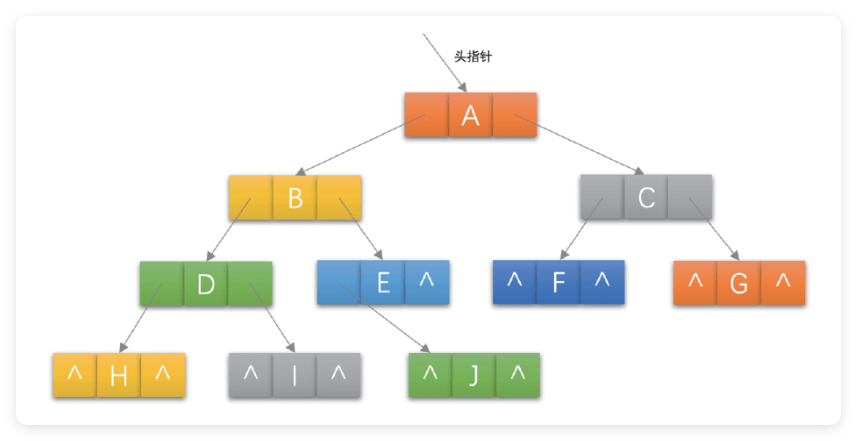
每个结点设两个指针,一个指向"第一个孩子",另一个指向"下一个兄弟"。这种表示法把任意树转换成二叉树结构。
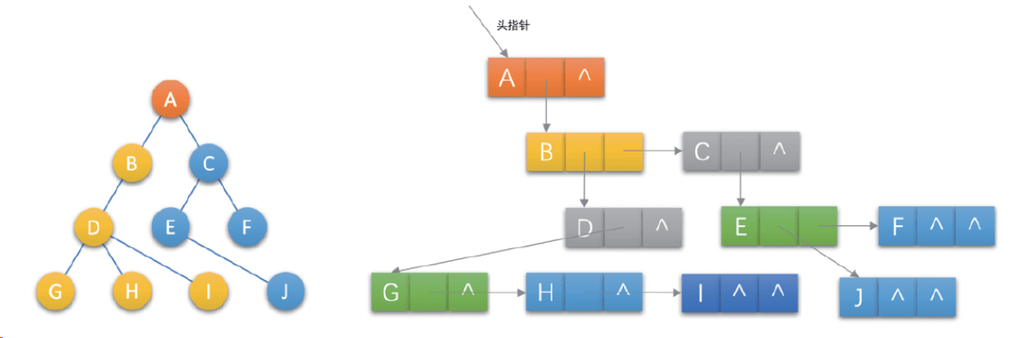
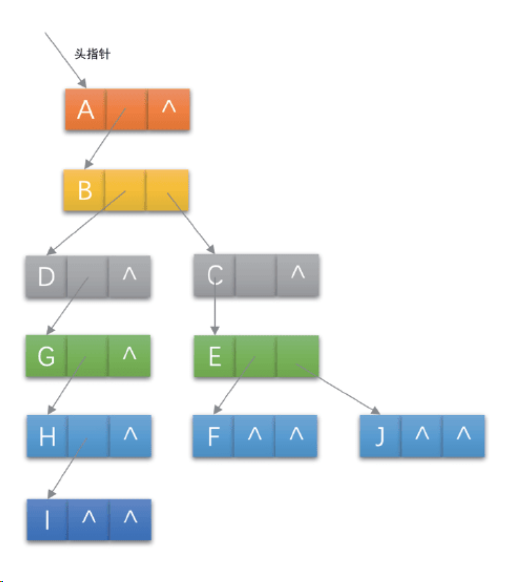
二叉树的形式
typedef int ElemType;

typedef struct CSNode {
    ElemType data;                        // 数据元素
    struct CSNode *firstchild;            // 指向第一个孩子
    struct CSNode *nextsibling;           // 指向下一个兄弟
} CSNode, *CSTree;特点:
- 结构最灵活,结点数不受固定数组大小限制,便于动态分配。
- 找孩子:通过
firstchild再沿nextsibling遍历兄弟。 - 找双亲:需要从根开始遍历,不太方便。
- 任意树都可唯一转换为二叉树,因此常与"树与二叉树转换"结合使用,是最常用的树存储结构之一。
6.2 - 二叉树
一、二叉树基础知识
(一)二叉树定义
二叉树(Binary Tree)是 个结点的有限集合,该集合或者为空集(空二叉树),或者是由一个根节点和两棵互不相交的、分别称为根节点的左子树和右子树的二叉树组成的。
二叉树的定义是一种递归定义。
(一)二叉树的特点
- 度严格不超过 2,只能是 0、1 或 2;
- 左右子树的次序严格固定,也就是交换了左、右子树的二叉树不是原来的二叉树;
- 二叉树有五种基本形态:
- 空二叉树(没有任何结点);
- 只有一个根结点;
- 只有左子树(右子树为空);
- 只有右子树(左子树为空);
- 空二叉树(左子树和右子树均为空);
(三)特殊二叉树
斜树(Skewed Tree)
- 左斜树:所有结点都只有左子树。
- 右斜树:所有结点都只有右子树。
- 本质:结构退化为线性表,但不建议直接说线性表是树的一种特殊形式,可以说它是树的一种受限特例。
满二叉树(Full Binary Tree)
- 定义:所有分支结点都有左孩子和右孩子,所有的叶子结点都在同一层上;
- 特征:叶子结点只能在最下层,非叶子结点的度都是 2;在同样深度的二叉树中,满二叉树的结点数、叶子数都最多。
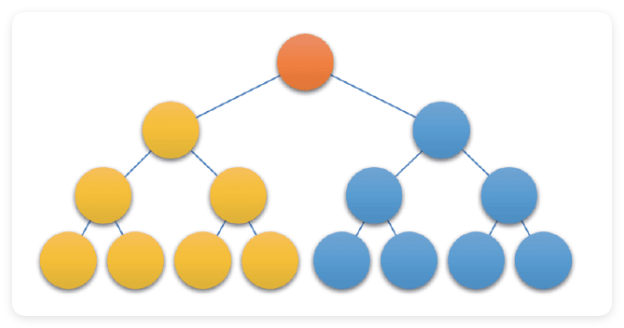
满二叉树
完全二叉树(Complete Binary Tree)
- 定义:对具有 n 个结点的二叉树按层序编号(从上到下,从左到右)。如果编号为
i的结点,与同深度的满二叉树中编号为i的结点位置完全一致,则称其为完全二叉树。 - 直观理解:在满二叉树的基础上,只允许在最后一层的最右侧缺失几个连续结点。下图中,如果编号 1~9 的结点有缺失的话,它就是不能算作完全二叉树的。
- 特征:叶子节点只能在最下两层;最下层的叶子节点是靠左连续排列的;至多存在一个度为 1 的结点,且该结点的孩子只能是左孩子(图中 5)。
一般用数组实现时,下标为 0 的位置空着不用(或者存储树的结点数、伪头节点),从下标为 1 的地方开始。
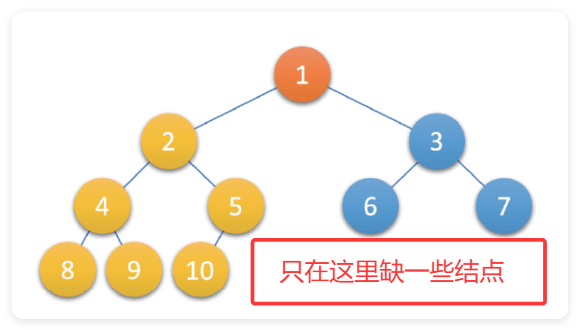
完全二叉树
(四)二叉树的性质
二叉树有五个主要的性质,了解并记住这些性质可以更好地利用二叉树。
性质一
二叉树在第 层至多有 个结点;
- 例如:第一层 1 个、第二层 2 个、第三层 4 个、第四层 8 个……
- 这个很显然,不需要推导。
性质二
深度为 k 的二叉树至多有 个结点;
- 例如:一层最多 1 个、两层最多 1+2=3 个、三层最多 1+2+4=7 个……
- 因为是“至多”,所以算的其实是满二叉树的结点数;
- 推导:由 性质 1 通过等比数列求和得到。
性质三
对任何一棵二叉树 T,如果其终端(叶子)节点数为 ,度为 2 的节点数为 ,则 ;
- 字面意思:叶子节点的数量永远比有两个孩子的结点多 1;
推导:
假设一棵二叉树中,度为 p 的结点(叶子)数量为 、总结点数为 ;
- 从【结点总数】的角度看,必然有 ;
- 从【树的边数(分支数)】的角度看:
- 从下往上看:除了根节点外,其余每个结点( 个)上方都有一条边连向它,这么看总边数是 ;
- 从上往下看:每个结点都向下发出 0 / 1 / 2 条边,总边数就是 。
- 另两个式子相等,即 ;
- 其中的 n 用上面的式子替换,就能得到 ,化简后得到 ;
性质四
具有 n 个结点的完全二叉树的深度为 。
- 类似性质 2 的一个反向版,但性质 4 只针对完全二叉树;
推导:
- 上界:一颗深度为 k 的完全二叉树,第 k 层可以不满,由性质 2 有 ,也就是 ;
- 下界:因为前 层必须满,所以 ,同理 ;
- 合起来看,,两边同时取对数,得到 ;
- 由于深度 k 是整数,所以 。
性质五
用一句话概括:编号 i 的父结点是 ,左孩子是 ,右孩子是 ,编号超过 n 就是孩子不存在。
对于一棵有 n 个结点的完全二叉树,若按层序编号(从 1 到 n),结点编号就对应数组下标,那么对于任意结点 :
- 双亲结点位置:
- 若 ,则结点 是根结点,无双亲。
- 若 ,则其双亲结点的编号为 (向下取整,即整除 )。
- 左孩子位置:
- 若 ,则结点 无左孩子(说明 是叶子结点,因为对于完全二叉树,如果没有左孩子,也就一定没有右孩子)。
- 若 ,则其左孩子结点的编号为 。
- 右孩子位置:
- 若 ,则结点 无右孩子。
- 若 ,则其右孩子结点的编号为 。
性质 5 是数组实现堆(Heap)数据结构(如大顶堆、小顶堆及堆排序)的核心理论依据,无需指针即可直接利用下标计算出左右孩子和双亲结点。以后会详细介绍。
二、二叉树的存储
在上一篇文章【6.3 - 树的存储】中,我们已经了解过,存储树这种一对多的关系结构是比较复杂的。而二叉树是一种特殊的树,有比一般的树更好存储方式。
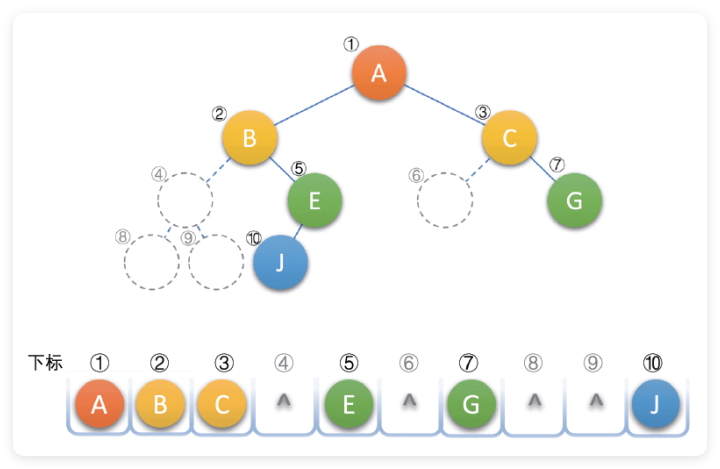
(一)顺序存储
对每个节点位置进行层序编号,就可以实现顺序存储,无论是否是完全二叉树都可以顺序存储,没有结点的位置留空即可。
但是,顺序存储一般只用于完全二叉树,因为非完全二叉树使用顺序存储会造成空间浪费(最极端的例子是右斜树)。
(二)二叉链表
二叉树的每个结点最多有两个孩子,所以可让每个结点包含一个数据域和两个指针域,分别存储该结点的数据和其左、右孩子的地址。
typedef struct BiTNode
{
    TElemType data;
    struct BiTNode *lchild,*rchild;
} BiTNode,*BiTree;