[数据结构] 06 - 2 - 二叉树的遍历
6.3 - 二叉树的遍历
二叉树遍历(Traversing binary tree)是指从根节点出发,按照某种次序依次访问二叉树中的所有节点,使得每个节点被访问且仅被访问一次。
- 访问:根据实际需求决定要做什么,比如打印数据、计算等(触达某个结点并不等于访问);
- 次序:不同于线性结构(只有从头至尾、循环、双向等简单的遍历方式),树的结点之间不存在唯一的前驱和后继关系,所以需要考虑次序。
6.3.1 - 递归遍历(深度优先, DFS)
前序、中序、后序有一个共同点:都是先一路往树的深处走,走到叶子节点再回头,去走另一条分支。这种"能往深走就往深走,走不了再回退"的遍历思路,叫做深度优先遍历(DFS)。
前序、中序、后序,本质上都是深度优先遍历,它们的区别只在于访问根节点的时机不同:
- 前序:先访问根,再深入左右子树;
- 中序:先深入左子树,再访问根,再深入右子树;
- 后序:先深入左右子树,最后访问根。
一、前序遍历
前序遍历:如果树为空,则返回;否则先访问根节点,然后前序遍历左子树、再前序遍历右子树。
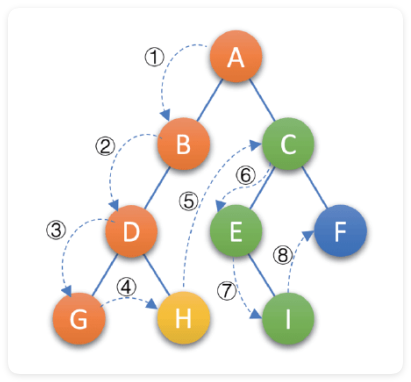
遍历顺序是:ABDGHCEIF
代码实现:
/* 二叉树的前序遍历递归算法 */
/* 初始条件:二叉树 T 存在 */
/* 操作结果:前序递归遍历 T */
void PreOrderTraverse(BiTree T)
{
    if(T==NULL)
        return;
    printf("%c",T->data);        /* 显示结点数据,可以更改为其他对结点的操作 */
    PreOrderTraverse(T->lchild); /* 先序遍历左子树 */
    PreOrderTraverse(T->rchild); /* 先序遍历右子树 */
}
前序遍历例子
递归进行前序遍历例子:
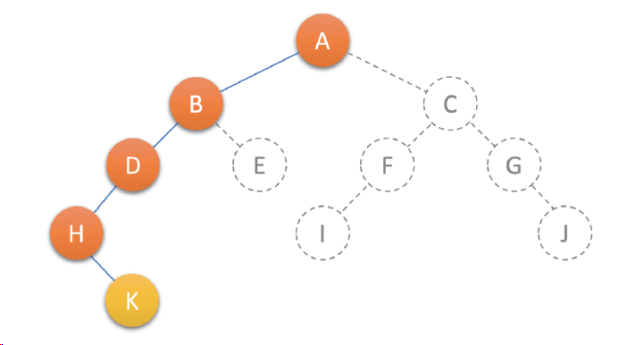
- 先递归遍历左子树,沿当前结点的左孩子向下遍历,直到穷尽;
- 遇到 H 后,H 没有左子树,所以访问右子树 K,然后返回上一级函数;
- 因为 D 没有右子树,所以再返回上一级函数;
- 返回至 B,访问其右子树 E,因为 E 没有左、右子树,所以返回到 B;
- B 结束,再返回上一级 A,然后从 A 开始前序遍历右子树。
二、中序遍历
中序遍历:如果树为空,直接返回;否则从根节点开始(注意不是访问根节点),中序遍历左子树,然后访问根节点,最后中序遍历右子树
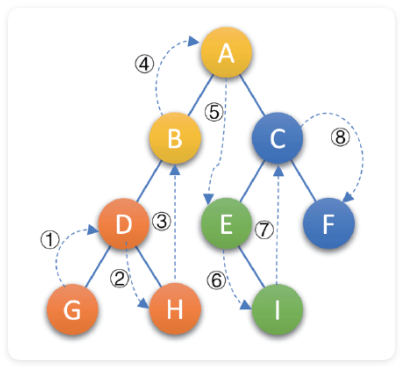
遍历顺序是:GDHBAEICF
代码实现:
void InOrderTraverse(BiTree T)
{
    if(T==NULL)
        return;
    InOrderTraverse(T->lchild);
    printf("%c",T->data);
    InOrderTraverse(T->rchild);
}- 与前序遍历相比,只是交换了一个顺序;
- 遍历时,先一路向左深入,直到找不到左孩子为止;
- 对于每一个结点,都等待其左子树全部遍历完毕后,再进行访问(也就是实际的操作,此处只是打印数据)。
三、后序遍历
后序遍历:如果树为空,直接返回;否则以从左到右、先叶子后结点的方式,遍历访问左右子树,最后访问根节点。
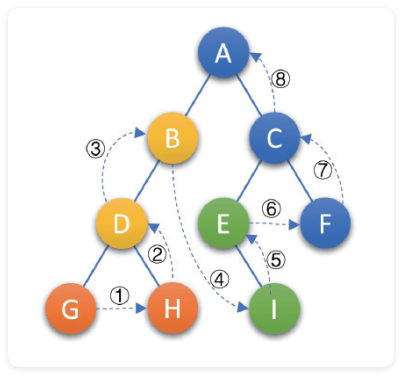
遍历顺序是:GHDBIEFCA
void PostOrderTraverse(BiTree T)
{
    if(T==NULL)
        return;
    PostOrderTraverse(T->lchild);
    PostOrderTraverse(T->rchild);
    printf("%c",T->data);
}- 后序遍历遵循左子树→右子树→根节点的访问顺序,其触达结点的顺序和前序遍历一样,只是在最后才访问根节点;
6.3.2 - 非递归遍历
前序、中序和后序遍历都可以不使用递归,而是显式地使用栈实现。
递归本身就依赖调用栈。非递归遍历的本质,就是自己用栈,模拟递归过程中系统调用栈保存节点、返回节点的行为。
一、为什么离不开栈
当函数调用另一个函数时,必须记住自己执行到了哪里,以便将来继续执行。系统通过调用栈(Call Stack)保存这些信息。
以 preorder(A) 为例(括号内是栈的情况,右侧为栈顶):
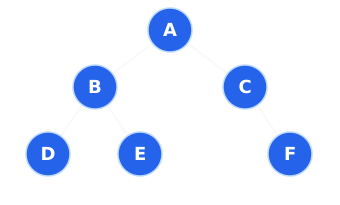
- 进入
preorder(A),A 压入栈(A) - 调用
preorder(B),B 压入栈(A B) - 调用
preorder(D),D 压入栈(A B D) - D 处理完成、出栈,返回 B(
A B) - B 接着处理右子树,使得 E 压入栈(
A B E) - E 处理完成、出栈,返回 B(
A B) - B 处理完成、出栈,返回 A(
A),按照同样方式处理 A 的右子树。
二、非递归前序遍历
思路
前序遍历的访问顺序是:根 → 左 → 右。而栈是后进先出(LIFO)的,如果想先处理左子树,那么就要先将右孩子入栈,再将左孩子出栈,这样到时候就是左孩子先出栈了(“访问”是在出栈时发生的)。
所以,算法的思路就是:
- 根结点入栈。
- 第一:只要栈不为空,就弹出一个结点并访问。
- 第二:如果它有右孩子,先把右孩子入栈。
- 第三:如果它有左孩子,再把左孩子入栈。
- 重复以上三个操作。
C 语言实现:
void preorder(TreeNode *root) {
    if (root == NULL) return;

    Stack S;
    initStack(&S);

    push(&S, root);

    while (!isEmpty(&S)) {
        TreeNode *p = pop(&S);

        visit(p);

        // 注意:右孩子先入栈
        if (p->right != NULL)
            push(&S, p->right);

        // 左孩子后入栈,因此先出栈
        if (p->left != NULL)
            push(&S, p->left);
    }
}- 根节点先入栈(如果为空直接返回);
- 每次从栈中弹出一个结点
p,并立即访问该结点(visit(p)); - 然后先让该结点的右孩子入栈,再让左孩子入栈,这样能保证左孩子先出栈。
三、非递归中序遍历
思路
中序遍历的访问顺序是:左 → 根 → 右。中序比前序更复杂,因为不能再第一次遇到某个结点时就访问它,而是要等待它的左子树全部处理完毕。
算法的思路是,维护一个指针 p,初始指向根节点:
- 当
p != NULL,将p入栈,并使p = p->left; - 不断重复直到
p == NULL,说明已经触达左子树最深处; - 此时开始弹出栈顶,并访问;
- 再令
p = p->right,处理其右子树; - 直到
p == NULL且栈为空(p 不为空说明还有新的子树要探索,栈不为空说明还有祖先节点未处理)。
C 语言实现:
void inorder(TreeNode *root) {
    Stack S;
    initStack(&S);

    TreeNode *p = root;

    while (p != NULL || !isEmpty(&S)) {

        // 第一阶段:一路向左
        while (p != NULL) {
            push(&S, p);
            p = p->left;
        }

        // 第二阶段:访问栈顶
        p = pop(&S);
        visit(p);

        // 第三阶段:转向右子树
        p = p->right;
    }
}
到达最后一个左叶子结点的时候,不是直接访问然后弹栈,回到其双亲结点,而是会经历这样的过程:
- 将左叶子结点入栈(
push(&S, p)),尝试触达其左孩子(p = p->left); - 发现左孩子为 NULL,离开 while 循环;
- 弹栈(弹出左叶子,
p = pop(&s))、访问(visit(p)),此时栈顶是左叶子的双亲结点; - 尝试触达其右孩子(
p = p->right),回到第一阶段; - 因为右孩子为 NULL,所以无法进入循环,直接进入第二阶段;
- 弹出并访问栈顶(即叶子节点的双亲节点),完成这次回溯。
四、非递归的后序遍历
思路:
非递归的后序遍历和前、中序相比是更难的,因为其访问操作是在处理完所有的左、右子树之后进行的。相比于中序,后序遍历还需要知道一个结点的右子树是否已经全部访问。
【方法一】使用两个栈:
后序的顺序是:左→右→根,反过来就是:根→右→左,非常容易通过对前序遍历稍作修改来实现。我们可以:
- 使用栈
S1,用前序的思路实现「根 → 右 → 左」(先左孩子,再右孩子)。 - 访问结点时,不立即输出,而是压入第二个栈
S2。 - 最后依次弹出
S2,得到「左 → 右 → 根」。
void postorder(TreeNode *root) {
    if (root == NULL) return;

    Stack S1, S2;
    initStack(&S1);
    initStack(&S2);

    push(&S1, root);

    while (!isEmpty(&S1)) {
        TreeNode *p = pop(&S1);

        push(&S2, p);

        // 注意:这里先左后右
        if (p->left != NULL)
            push(&S1, p->left);

        if (p->right != NULL)
            push(&S1, p->right);
    }

    while (!isEmpty(&S2)) {
        visit(pop(&S2));
    }
}
【方法二】只用一个栈:
沿用一路向左的思路,但当一个结点来到栈顶的时候,需进一步判断:
- 如果它的右子树还没有处理,就先处理右子树;
- 如果它的右子树都处理完了,就进行访问。
为了判断其右子树是否已经处理,要引入一个指针 lastVisited 记录最近一次访问完成的结点:
- 如果
lastVisited == p->right,则说明右子树已经处理完毕,因为后序遍历中,右子树最后被访问的结点就是右子树根; - 否则,说明右子树还没有访问,那么就要让
p = p->right; - 每次访问一个节点的时候,都更新这个指针。
void postorder(TreeNode *root) {
    Stack S;
    initStack(&S);

    TreeNode *p = root;
    TreeNode *lastVisited = NULL;

    while (p != NULL || !isEmpty(&S)) {

        if (p != NULL) {
            // 一路向左
            push(&S, p);
            p = p->left;
        }
        else {
            // 查看栈顶,但先不弹出
            p = peek(&S);

            if (p->right != NULL &&
                lastVisited != p->right) {

                // 右子树尚未处理
                p = p->right;
            }
            else {
                // 左右子树均处理完毕
                visit(p);
                lastVisited = p;

                pop(&S);
                // 置空
                p = NULL;
            }
        }
    }
}需要注意,访问完一个节点后应将其置空,否则下一次循环又会使该结点入栈并不断向左深入,造成重复处理和死循环:
p != NULL:表示还要沿着当前节点继续向左深入;p == NULL:表示当前这条向下的路已经走完,需要回到栈中处理祖先节点。
6.3.3 - 层序遍历(广度优先, BFS)
一、什么是广度优先遍历
BFS 是一种通用的搜索策略,层序遍历是 BFS 在树结构上的典型应用。
- DFS(深度优先搜索):优先沿一条路径不断深入,无法继续时再回溯。
- BFS(广度优先搜索):优先访问距离起点较近的结点,逐层向外扩展。
层序遍历:若树为空,则直接返回;否则从第一层(根节点)开始访问,从上而下逐层遍历,在同一层中按从左到右的顺序逐个结点访问。
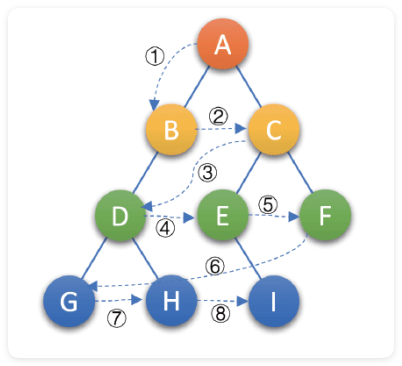
遍历顺序是:ABCDEFGHI
二、层序遍历思路
DFS 是利用栈后进先出(LIFO)的特性实现的;而 BFS 希望先发现的结点先被处理,因此利用的是队列先进先出(FIFO)的特性。
每处理一个结点,都做相同的三件事:
- 从队首取出一个结点;
- 访问该结点;
- 将该结点非空的左、右孩子依次加入队尾。
为什么可保证从左到右、从上到下的顺序?
- 每一层中:双亲结点在将孩子入队时,都是先左孩子、再右孩子的顺序;
- 对于各层:开始处理下一层的结点时,原先层的结点一定已经全部入队了,新的层总是排在原先层的所有结点之后,保证了从上到下逐层遍历。
一个例子
再次以这个二叉树为例
如上图中,初始时根节点 A 先入队:
- 根节点 A 出队,依次让 B、C 入队(
B C); - 队首的 B 出队、D 入队(
C D); - C 出队、EF 入队(
D E F); - D 出队、GH 入队(
E F G H); - E 出队,I 入队(
F G H I); - 队列中剩下的结点依次出队。
三、代码实现
用 C 语言实现 BFS(front:指向队首元素;rear:指向下一个可入队的位置)
void LevelOrder(TreeNode *root) {
    if (root == NULL)
        return;

    TreeNode *queue[MAXSIZE];
    int front = 0;
    int rear = 0;

    // 1. 根结点入队
    queue[rear++] = root;

    // 2. 队列非空时,持续遍历
    while (front < rear) {
        // 取出队首结点
        TreeNode *p = queue[front++];

        // 访问当前结点
        printf("%c ", p->data);

        // 左孩子入队
        if (p->left != NULL)
            queue[rear++] = p->left;

        // 右孩子入队
        if (p->right != NULL)
            queue[rear++] = p->right;
    }
}
6.3.4 - 根据遍历序列重建二叉树
一、推导遍历结果(知二推一)
有一种常见的数据结构题目,是给出前序和中序遍历结果,要求写出后序遍历的结果(或给后 / 中求前,如果不给出中序遍历是无法确定一个二叉树的)。
- 找根:前序第一个元素、后序最后一个元素为根节点;
- 中序分左右:利用根信息,分出左右子树,即
[左子树所有节点] 根 [右子树所有节点]; - 再次找根、再分左右:在前后序中,再找子树的根节点,然后再去中序分左右,重复直到还原整个二叉树。
例题:
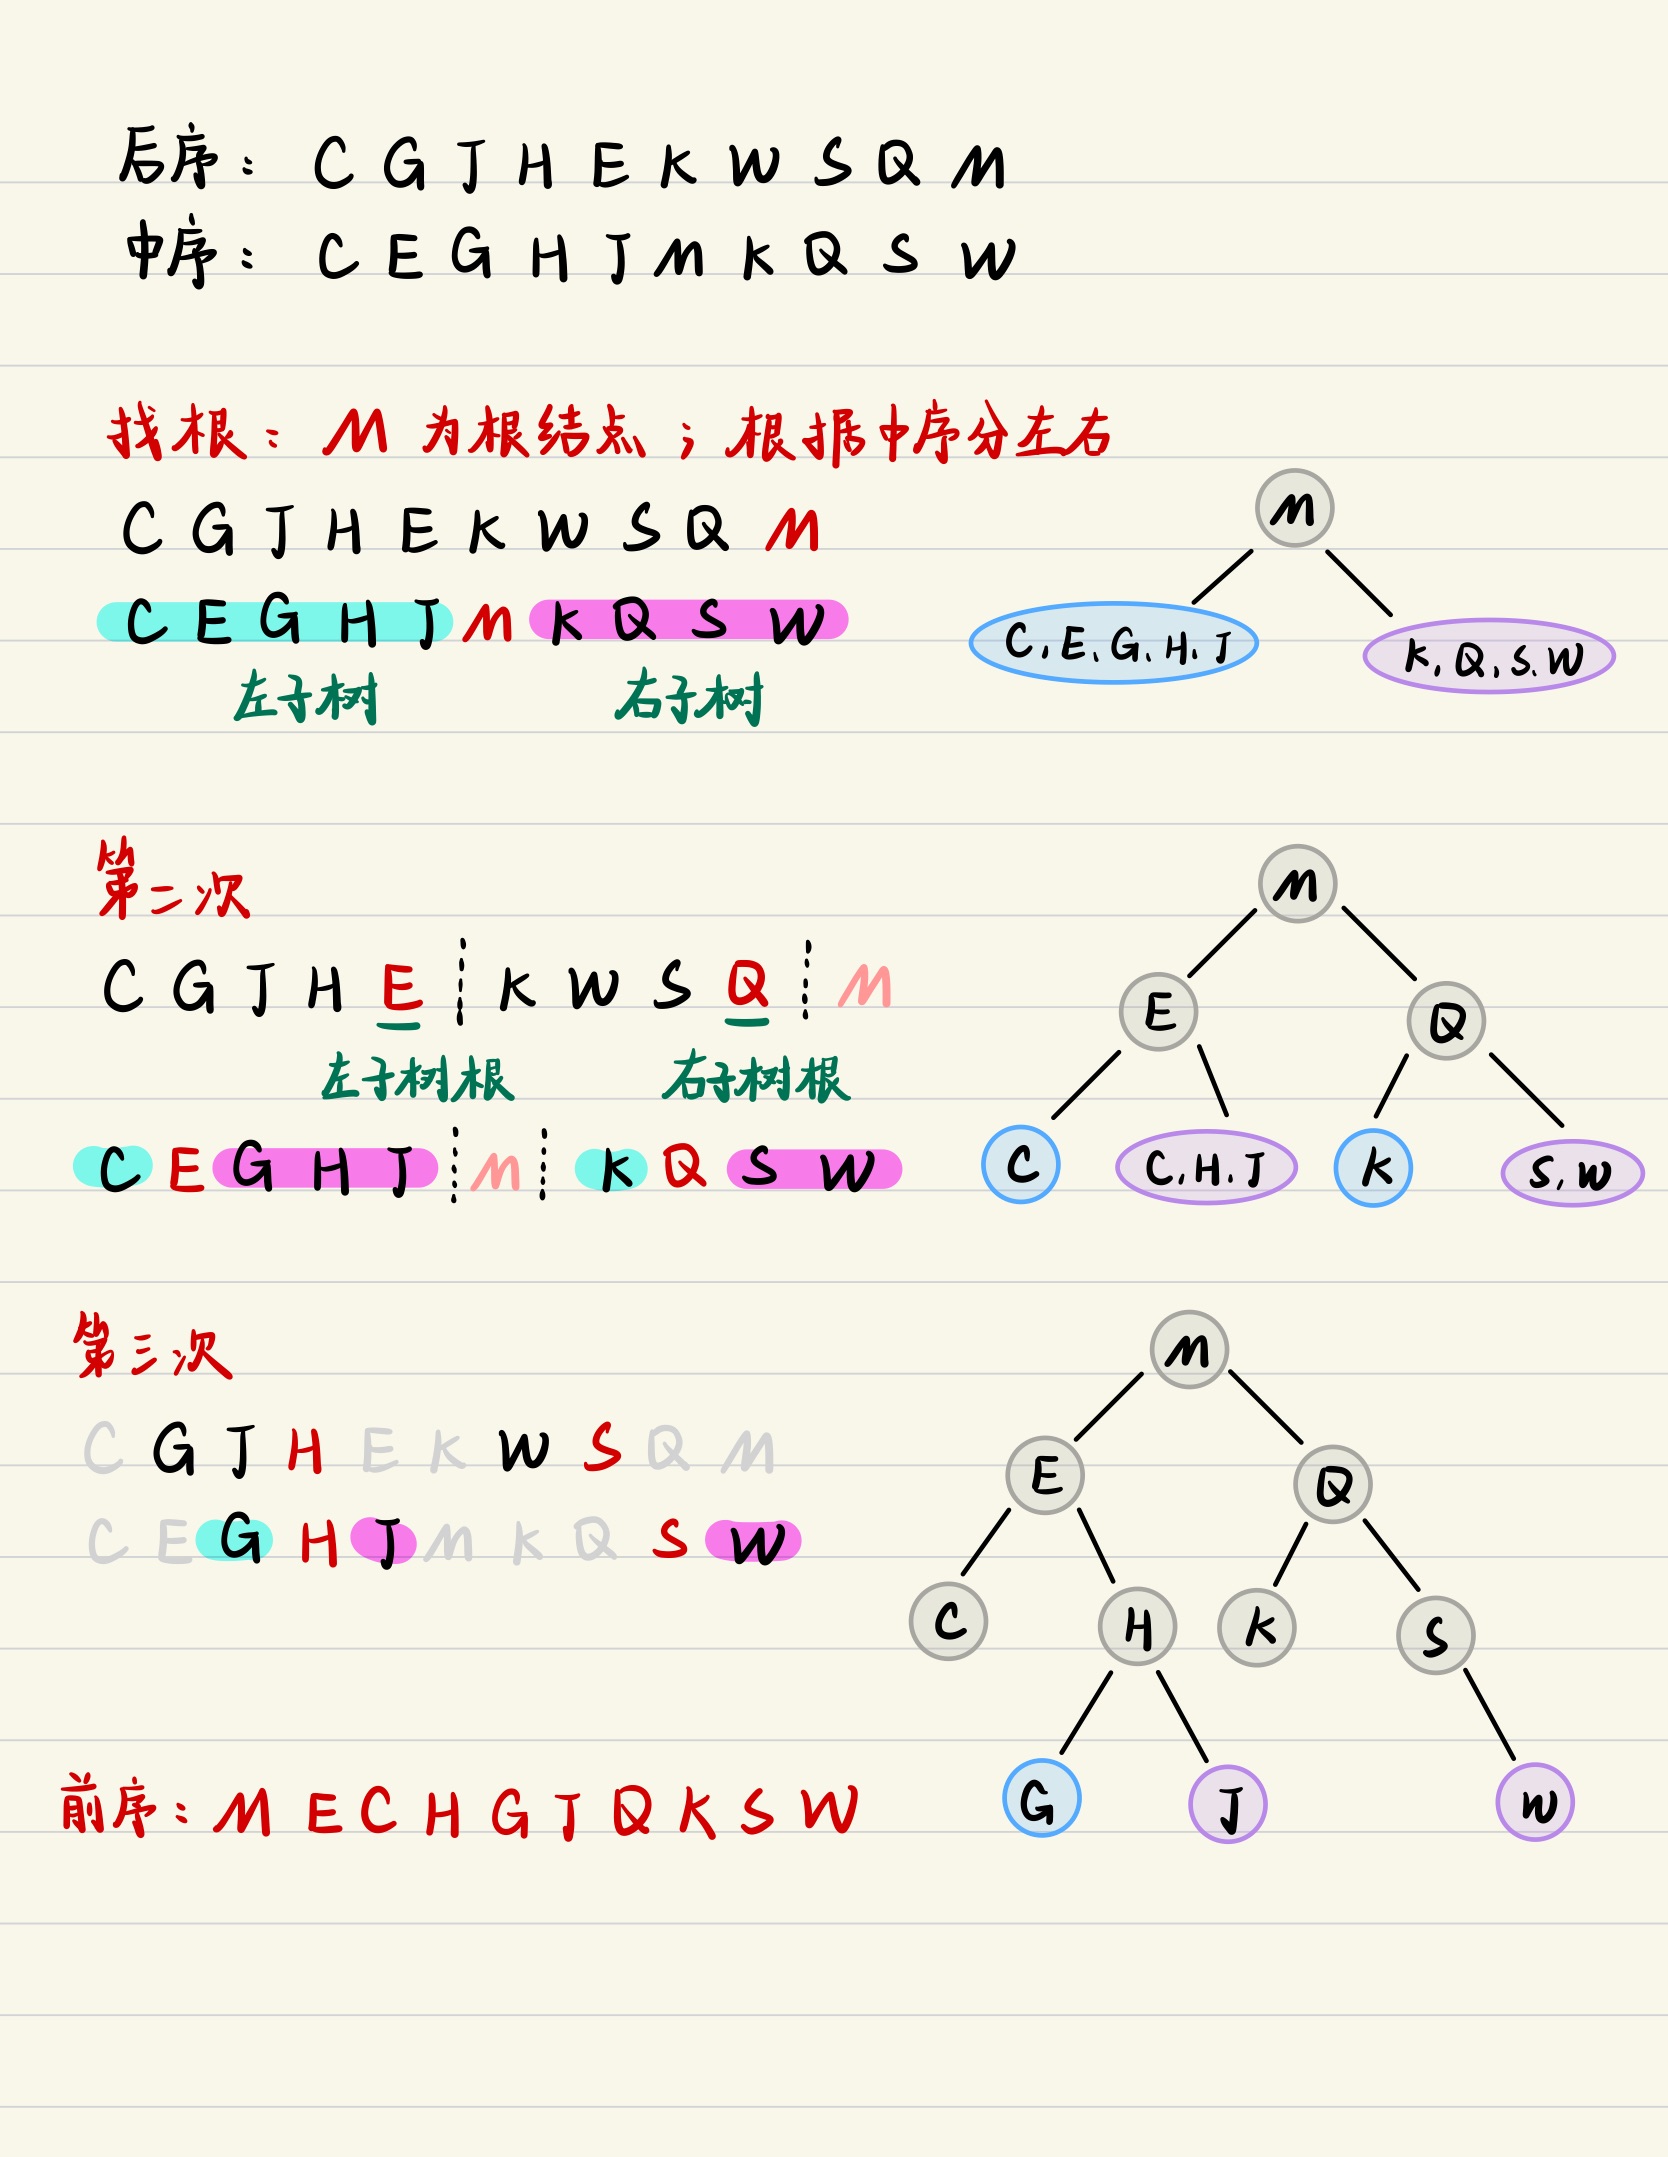
由中序 / 后续遍历推导前序遍历的方法
二、二叉树的建立
立二叉树的核心思想,就是利用前序遍历(根→左→右)把一串字符序列还原为一棵树的结构;
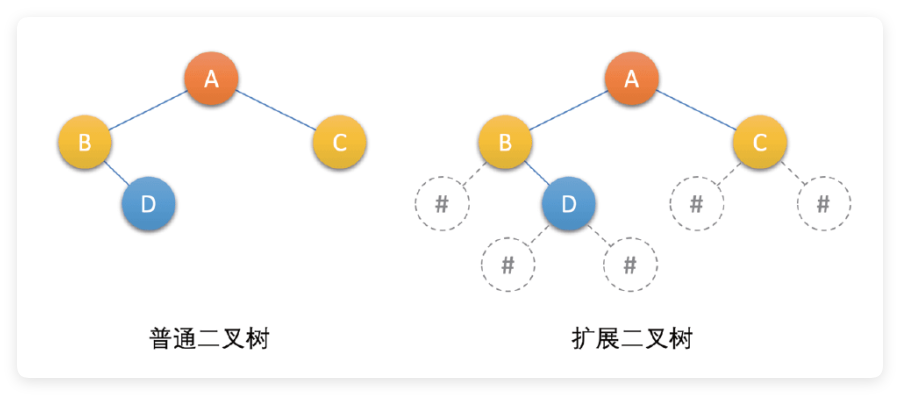
- 仅凭前序遍历序列,无法确定唯一的一棵二叉树的结构,因为我们不知道哪些结点有空子树;
- 为解决歧义,我们在每个结点的空指针处补上虚结点“
#”,得到扩展二叉树。
代码实现:
通过一个字符串建立一个二叉链表结构的二叉树:
#include <stdio.h>
#include <stdlib.h>

#define OVERFLOW -2

typedef char TElemType;

typedef struct BiNode {
    TElemType data;           // 结点数据域
    struct BiNode *lchild;    // 左孩子指针
    struct BiNode *rchild;    // 右孩子指针
} BiNode, *BiTree;


/* 按前序输入二叉树中结点的值(一个字符) */
/* #表示空树,构造二叉链表表示二叉树T */
void CreateBiTree(BiTree *T)
{
    TElemType ch;

    scanf("%c", &ch);
    ch = str[index++];

    if (ch == '#')
        *T = NULL;
    else
    {
        *T = (BiTree)malloc(sizeof(BiNode));
        if (!*T)
            exit(OVERFLOW);
        (*T)->data = ch;               /* 生成根结点 */
        CreateBiTree(&((*T)->lchild)); /* 构造左子树 */
        CreateBiTree(&((*T)->rchild)); /* 构造右子树 */
    }
}- 遇到“
#”,则将指针设为 NULL,表示一个空结点,然后返回上一层; - 遇到正常字符,malloc 动态生成一个结点,赋值,然后递归建立左右子树。
6.3.5 - 二叉树遍历的应用
一、求二叉树高度
回顾二叉树高度:从根结点到最远叶子结点所经过的边数(或结点数,根据定义不同略有差异,通常指最大层数)。
思路:后序遍历
- 一棵树的高度等于其左子树高度和右子树高度的较大值,再加上根结点这一层(
+1); - 后序遍历是在完整地访问了所有的左、右子树之后才访问根节点,天然适合这个问题,每个结点的“访问”操作就是计算【左、右子树高度的较大值 + 1】并返回。
代码实现:
int treeHeight(TreeNode* root) {
    // 退出条件
    if (root == NULL) {
        return 0; // 空树高度为 0
    }
    int leftH = treeHeight(root->left);   // 递归求左子树高度
    int rightH = treeHeight(root->right); // 递归求右子树高度

    // 当前树高度 = 左右子树较大值 + 1
    return (leftH > rightH ? leftH : rightH) + 1;
}
二、统计结点数
思路:后序遍历
- 通过遍历整棵树,就可以解决这个问题;
- 每个结点的“访问”操作是【将左、右子树的高度求和 + 1】。
代码实现:
int countNodes(TreeNode* root) {
    if (root == NULL) {
        return 0;
    }
    // 左子树结点数 + 右子树结点数 + 根结点本身 (1)
    return countNodes(root->left) + countNodes(root->right) + 1;
}
三、统计叶子结点数
思路:叶子节点的特征是左、右孩子都为空,只在这种情况下返回 1,其他时候就只返回【左、右子树的叶子数求和】即可,而不再每次都 + 1(也就是让实际的数量增加只发生在叶子节点)
代码实现:
int countLeafNodes(TreeNode* root) {
    if (root == NULL) {
        return 0;
    }
    // 左右子树都为空,说明是叶子结点
    if (root->left == NULL && root->right == NULL) {
        return 1;
    }
    // 递归累加左右子树中的叶子结点数
    return countLeafNodes(root->left) + countLeafNodes(root->right);
}
四、判断两棵二叉树是否相同
“相同”的定义:两棵树的结构完全一致,并且对应位置上的结点值完全相同。
核心思路:同时遍历两棵树的对应结点,逐一比对
- 如果两棵树的当前结点都为空,说明对应位置匹配,返回
true。 - 如果其中一棵为空、一棵不为空,说明结构不匹配,返回
false。 - 如果两棵树都不为空,但根结点的值不相等,返回
false。 - 状态转移: 当前根结点相同后,还需判断“左子树相同”且“右子树相同”。
代码实现:
bool isSameTree(TreeNode* p, TreeNode* q) {
    if (p == NULL && q == NULL)    return true;
    if (p == NULL || q == NULL)    return false;
    if (p->val != q->val)          return false;

    return isSameTree(p->left, q->left) && isSameTree(p->right, q->right);
}
五、二叉树的镜像与结构变换
二叉树镜像(翻转二叉树)
给定一棵二叉树的根节点 root,要求把整棵树变成它的镜像树:
-
对树中的每一个节点,都把它的左子树和右子树交换;
-
节点中存储的值不变;
-
空节点仍然为空;
-
返回翻转后的根节点。
思路:
- 递归终止条件:如果当前结点为空,返回
NULL(空树的镜像还是空树); - 处理当前结点:交换左、右孩子;
- 递归处理左右子树;
代码实现:
TreeNode* invertTree(TreeNode* root) {
    if (root == NULL) {
        return NULL;
    }

    // 交换当前结点的左右子树指针
    TreeNode* temp = root->left;
    root->left = root->right;
    root->right = temp;

    // 递归对左右子树内部进行镜像翻转
    invertTree(root->left);
    invertTree(root->right);

    return root;
}